RoboJudge:给生成的机器人视频分开评物理与任务
与人类相关性更高,是否意味着已经能可靠筛选训练视频?
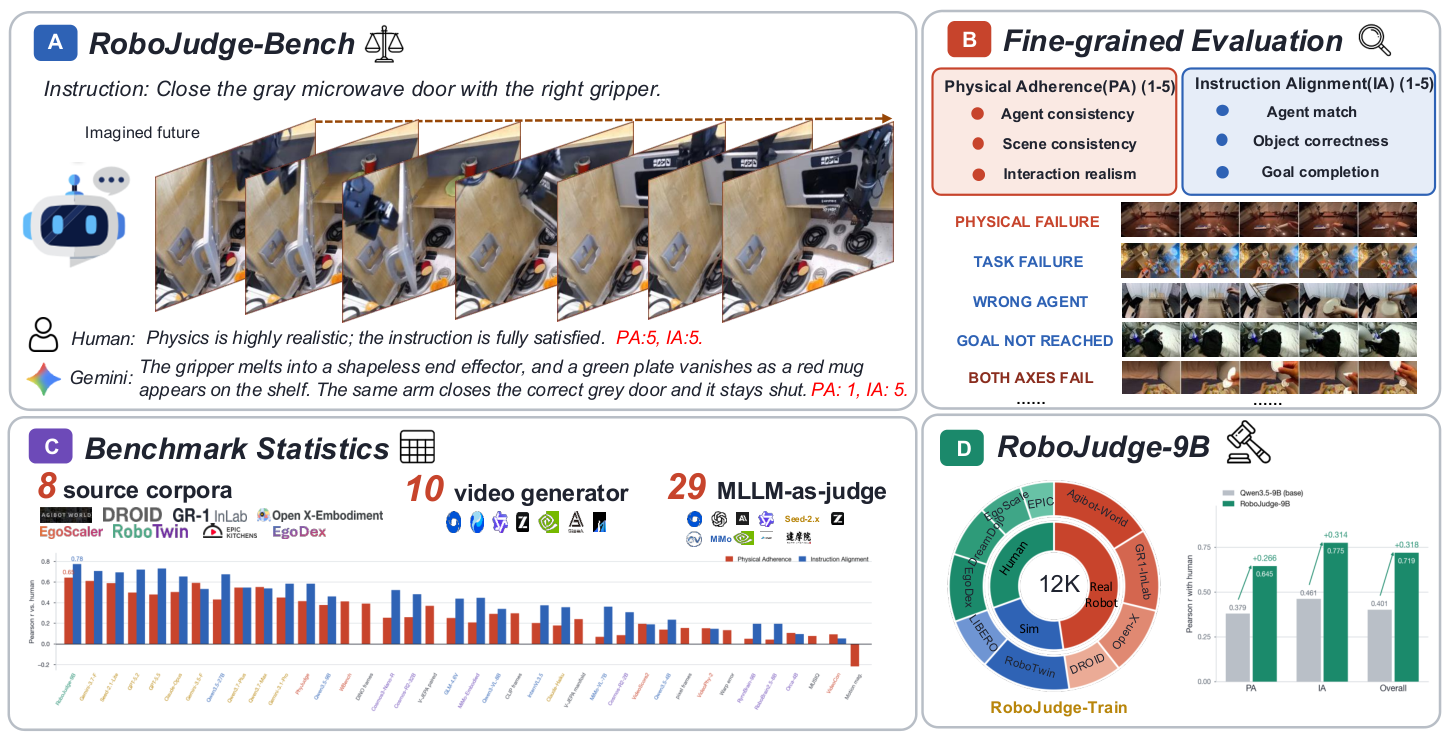
RoboJudge将生成操作视频的物理可信度与指令完成度分成两轴,并训练9B视觉语言裁判。整体人类评分相关性达到0.719,但这是相关系数,不是71.9%的正确率;物理评分相对最强基线的置信区间仍跨零。
图解主要方法
与人类相关性更高,是否意味着已经能可靠筛选训练视频?
- 1
1 · 图1把“像真的”与“做对了”拆开
Physical Adherence检查机器人、场景和交互一致性,Instruction Alignment检查执行者、对象及目标完成,两轴分别1–5分。一个动作物理合理却抓错物体时,不能用好看的视频抵消指令错误。
- 2
2 · 从人类审核标签构造训练集
评测集800视频来自8类源语料、10个生成器,人类评分经复核;训练集12351视频对应24702轴标签,包含11520生成片段及831真实成功片段。模型初始标签和解释需人工修订,源片段隔离不等于所有生成器完全域外。
- 3
3 · SFT学量表,GRPO强调精确分值
以Qwen3.5-9B全参数SFT一轮,再做200步GRPO;正确分值给离散奖励。4张H20上SFT约2小时、RL约12小时,每更新64提示、8候选共512完成。默认4fps、最多32帧,细微接触事件可能被采样遗漏。
- 4
4 · 相关性、精确命中与迁移各测一次
与人类相关并不保证每个分数都正确,跨数据集表现也不能替代机器人执行验证。作者还用裁判排名视频生成器,但那是本裁判的偏好结果,尚非独立人类确认或下游策略收益。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据总体Pearson r从底座0.401到SFT 0.700、RL 0.719;PA为0.645、IA为0.775,整体精确命中47.3%、MSE 0.747。 主表与训练消融 ↗
我的解读RL在SFT上继续增益较小,0.719不能改写为成功率。
来源证据按558源片段聚类重采样。相对最强基线,整体Δr=0.089,95%CI[0.061,0.119];PA Δr=0.034,CI[-0.011,0.078]。 附录E1:10000次分层簇bootstrap ↗
我的解读整体和指令轴证据更强;PA点估计最高不等于显著胜出。
来源证据VideoPhy物理相关0.179→0.346;Physion的Youden指数SFT 0.105、RL 0.093。另用50提示比较17生成器。 域外与生成器排名 ↗
我的解读迁移并非所有指标随RL上升,裁判排名需要独立人评防循环论证。
开放情况与使用许可
项目链接RoboJudge实际代码仓库,HF模型卡有model.safetensors并声明代码和权重Apache-2.0;上游数据仍按各来源条款。已核对文件存在及模型卡,未下载大权重或复现训练。
LICENSECC BY 4.0(论文及原图)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
双轴量表和按源片段聚类的统计检验,让“视频质量”更接近可解释、可审计的操作要求。
反方 · 哪些结论还不够
高分仍可能漏掉稀有物理错误;训练与测试分布、帧预算和裁判偏好限制外推。尚无用评分筛选后真实策略提升的闭环证明。
综合判断
适合做人工筛选的辅助排序器;对物理真实性和安全关键案例仍应保留人类复核。
我会先做的验证
未执行的验证方案:取未出现的机器人形态与生成器,人工双盲评分并分层审计碰撞、抓错对象和无进展片段;再用同等数量的随机/裁判筛选数据训练策略,比较真实执行而非仅裁判均分。