SpecSlot:让低频负责全局,高频留在局部
像素扩散的注意力计算,能否按频率职责重新分配?
SpecSlot在每个空间位置分配不同频率职责的token槽,只让低频槽承担全局通信,高频槽保留局部建模。它关注图像生成计算效率,适合作为视觉资产和纹理概念生产的上游研究;论文不生成UV贴图或物理材质。
图解主要方法
像素扩散的注意力计算,能否按频率职责重新分配?
- 1
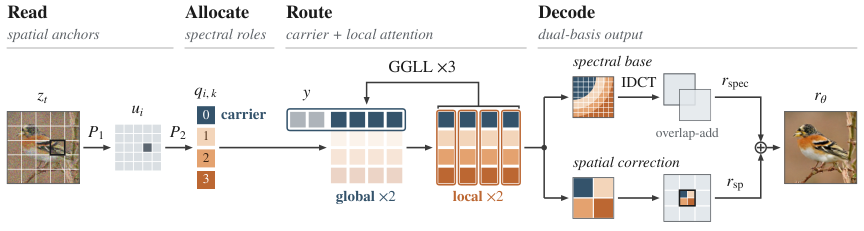
图2 Read/Allocate:空间锚点分成频率槽
在空间锚点W上建立K个slot,每个负责互不重叠的DCT径向频段。低频承载大尺度结构,高频承载细节;所有槽仍被计算,不是简单删去高频token。
- 2
Route:低频carrier做全局通信
只有slot0进入全局注意力,其余局部通信;以W256、K4为例,全局token含上下文为288,而全槽全局为1056。重复全局/局部层组织,让整体布局与细节分工而非每层都付全连接成本。
- 3
Decode:频域与空间残差共同重建
各槽输出频段系数,逆DCT后重叠相加;长度32窗口、步幅16、sqrt-Hann归一化缓解图像块边缘。另有零初始化空间修正分支补细节,它不受同样的频率所有权约束。
- 4
区分图像块缝与资产UV接缝
图中overlap-add解决二维分块重建的不连续,不知道UV岛、几何法线或PBR能量约束。用于纹理资产还需额外验证周期平铺、跨视角、去光照及粗糙度/金属度一致性。
实验与证据
已阅读正文及架构、实验设置、消融相关附录,核对实验条件与原图;未独立复现。
来源证据主结果5训练种子,消融3种子;120epoch、8GPU,50步Heun,每种子50000图,CFG按模型调节。256分辨率FID6.5921,95%区间6.386–6.798,与匹配JiT-CM相近。 主实验协议 ↗
我的解读低分辨率结果主要证明效率结构可用,并非巨大质量跃升;CFG调节也属于比较条件。
来源证据512时FID2.84,较匹配CM略低FLOPs;相对JiT-B16少38.2%计算但FID差.69。文生图DPG62.21对61.15,GenEval却由JiT-B8更好,前向计算省40.6%。 512与文生图 ↗
我的解读存在明确质量-计算折中,不应把前向FLOPs节省写成端到端同幅提速。
来源证据论文分别比较全局槽分配、局部交互与空间修正,支持低频carrier设计。 频段与修正消融 ↗
我的解读修正分支与训练设置也是收益来源,不能只凭频率直觉归因;暂无三维资产管线实验。
开放情况与使用许可
GitHub SpecSlot代码采用MIT;HF存在两个ImageNet及一个T2I的pth检查点,但未发现模型卡与明确权重许可,不能自动继承代码MIT。
LICENSE论文 CC BY 4.0;代码与权重许可另见开放范围
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
按频率分配全局通信提供可检查的计算结构,且主实验报告多种子而不只给单次最优样本。
反方 · 哪些结论还不够
图像指标与几何、UV、PBR无直接等价;质量折中和任务差异存在,权重许可尚未明确。
综合判断
适合关注高分辨率二维素材生成的效率研究,距离可直接交付材质仍需专门评测。
我会先做的验证
未执行的验证方案:在固定GPU、采样步数与CFG下比较总时延及纹理细节;再对无缝平铺、UV岛边缘和重光照资产集评估,不以FID代替接缝与物理指标。