RSI-Anything:把预测、反馈和版本验收放进同一个改进循环
跨领域复用更新协议,但各实验并未都验证策略与世界模型共同递归进化
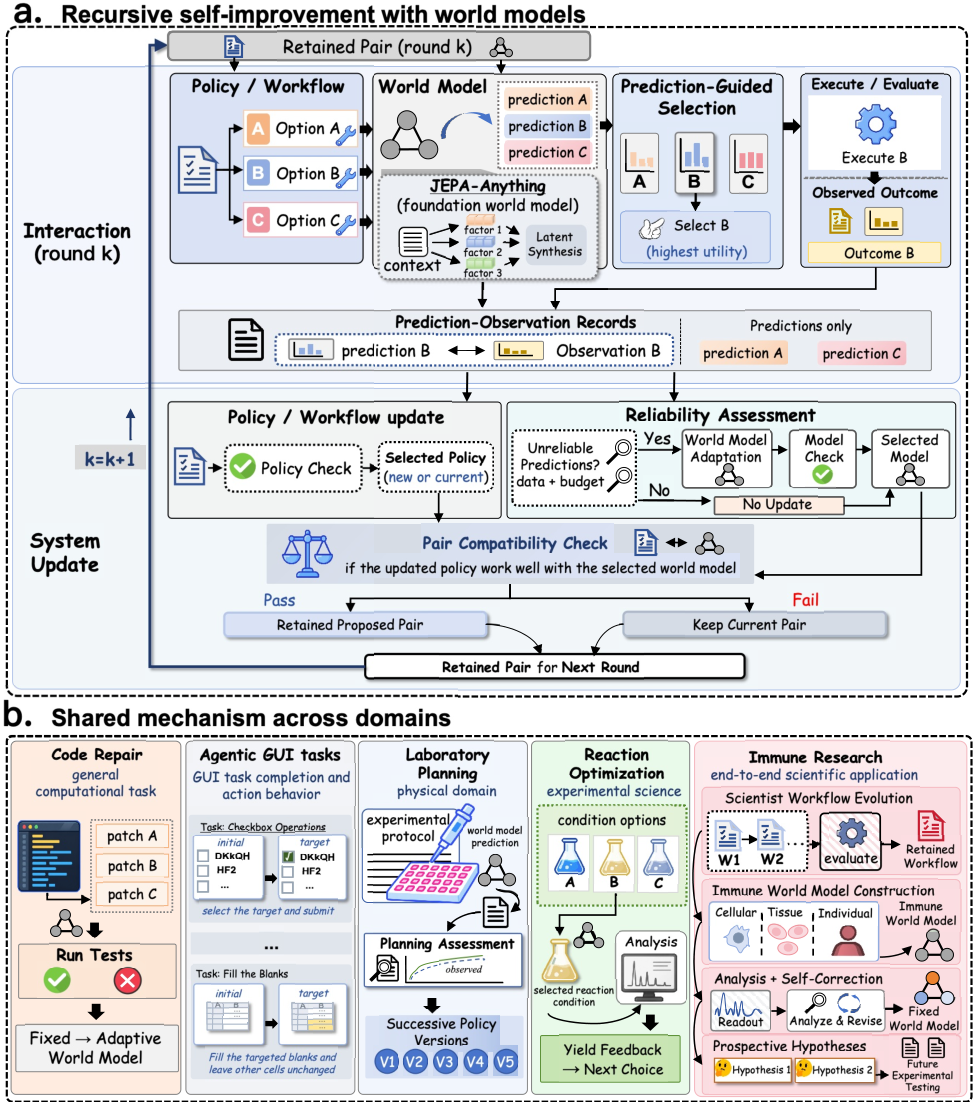
世界模型先预测候选动作后果,再把有限外部反馈用于选择与更新;只有通过组件和组合检查的新版本才保留。论文最有价值的部分是明确预测与观测、状态变化与模型更新的区别,而不是已经证明无限自我改进。
图解主要方法
跨领域复用更新协议,但各实验并未都验证策略与世界模型共同递归进化
- 1
先预测,再决定付费验证哪个候选
图2上部策略提出候选,JEPA-Anything式预测器输出潜在结果或结果分布。代码修复中固定7B coder提出四个补丁,3B执行预测器判断测试结果类别,只执行选中者;未执行候选只有预测,不能算观测证据。
- 2
按模型版本记录预测与反馈
图2中部将执行结果与当时预测配对。评估当前模型可靠性时只能用该版本预测,或在历史输入上重新预测;覆盖不足应记为证据不足,不能因为没观察到错误就判可靠。规则、模型、模拟与外部实测分别标来源。
- 3
策略和模型可以异步更新
反馈可以更新参数,也可以修改持久工作流。世界模型适配要求不可靠、数据足够且预算足够同时成立;只增加历史记录不算模型升级。不同领域开启的更新路径不同,固定预测表选下一实验也不能称每轮训练模型。
- 4
通过组件检查后还需组合验收
图2底部先查新策略或预测器,再比较新组合与当前组合;组合失败则保留原版本。策略变更会改变候选分布,因此预测器单独变准不保证新组合更好。任务目标、预算与验收标准应在运行前固定。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据CodeContests 200题×3种子、最多3轮,固定coder与每轮4候选。随机26.0%、静态验证器26.3%、固定世界模型29.2%、适配预测器31.2%;在线测试约3.71–3.72次/题。 §3.1、§6 ↗
我的解读支持选择与预测器适配收益,不能说coder参数共同进化;任务跨种子复用,区间应按任务聚类。
来源证据复选框成功51→79→99%,中间版错误提交21次、最终1次;OSWorld相对初始提升18.4%,不是18.4个百分点。LabHorizon同一200题五版本21.80→46.01%,对参考45.32%高0.69点。 §3.2–3.3 ↗
我的解读界面和实验室结果各有范围:协议评分不等于真实设备执行,重复评估也需防开发选择偏差。
来源证据论文报告流式LC–MS在40次观察时96.15%。官方发布说明明确是固定321条件池中回放已测产率,100个种子、8次初始观察;第10次均找到池内最优。 §3.4及官方reaction_optimization说明 ↗
我的解读不能改写成100次新湿实验或每轮重训世界模型。实际selector.py使用冻结均值和方差的期望改进,反馈只更新当前最好值并排除已测项。
来源证据免疫研究下游分析使用冻结预测器,提出SIRPα抑制与IL-36γ轴调节的前瞻假设,等待实验检验。 §3.5、讨论 ↗
我的解读这里是科学假设生成,不是已验证治疗效果;跨域结果拼合不能替代单任务长期双组件共同改进的证据。
开放情况与使用许可
GitHub已包含任务代码、测试和实际selector.py,自有代码Apache-2.0,第三方模型数据保留各自许可。化学资源为冻结预测表;Hugging Face目录本轮读取失败,未宣称所有领域权重均已核实。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
明确保留版本和预测观测对应关系,能减少把一次修答案或积累日志误认成系统自我改进;固定coder对照提供较清晰的增益归因。
反方 · 哪些结论还不够
不同领域验证的是不同子机制,尚缺单任务长期共同更新的完整闭环;化学公开复现是既有数据池回放,实验室为规划评分,免疫干预仍是假设。
综合判断
适合作为带验收的自我改进工作流设计。证据支持有限任务中的选择和适配收益,不支持泛化到任意领域的持续自主突破。
我会先做的验证
未执行的验证方案:预注册独立开发、门控与审计集;在同一任务跑多轮策略和预测器更新,记录每次拒绝及保留版本,并将总计算预算和外部验证次数与固定模型对照匹配。