RynnWorld-Latent:用共享潜动作连接不同机器人视频
跨形态视频预训练如何变成策略训练数据,又留下哪些错配?
模型从人类、机器人和仿真视频提取共享潜动作,训练动作条件视频生成器;适配目标机器人后,用数字遥操作或首帧编辑生成训练数据。论文也明确承认:动作重定向与生成视频是两个过程,时间对齐不能保证物理一致。
图解主要方法
跨形态视频预训练如何变成策略训练数据,又留下哪些错配?
- 1
用视觉变化统一接口
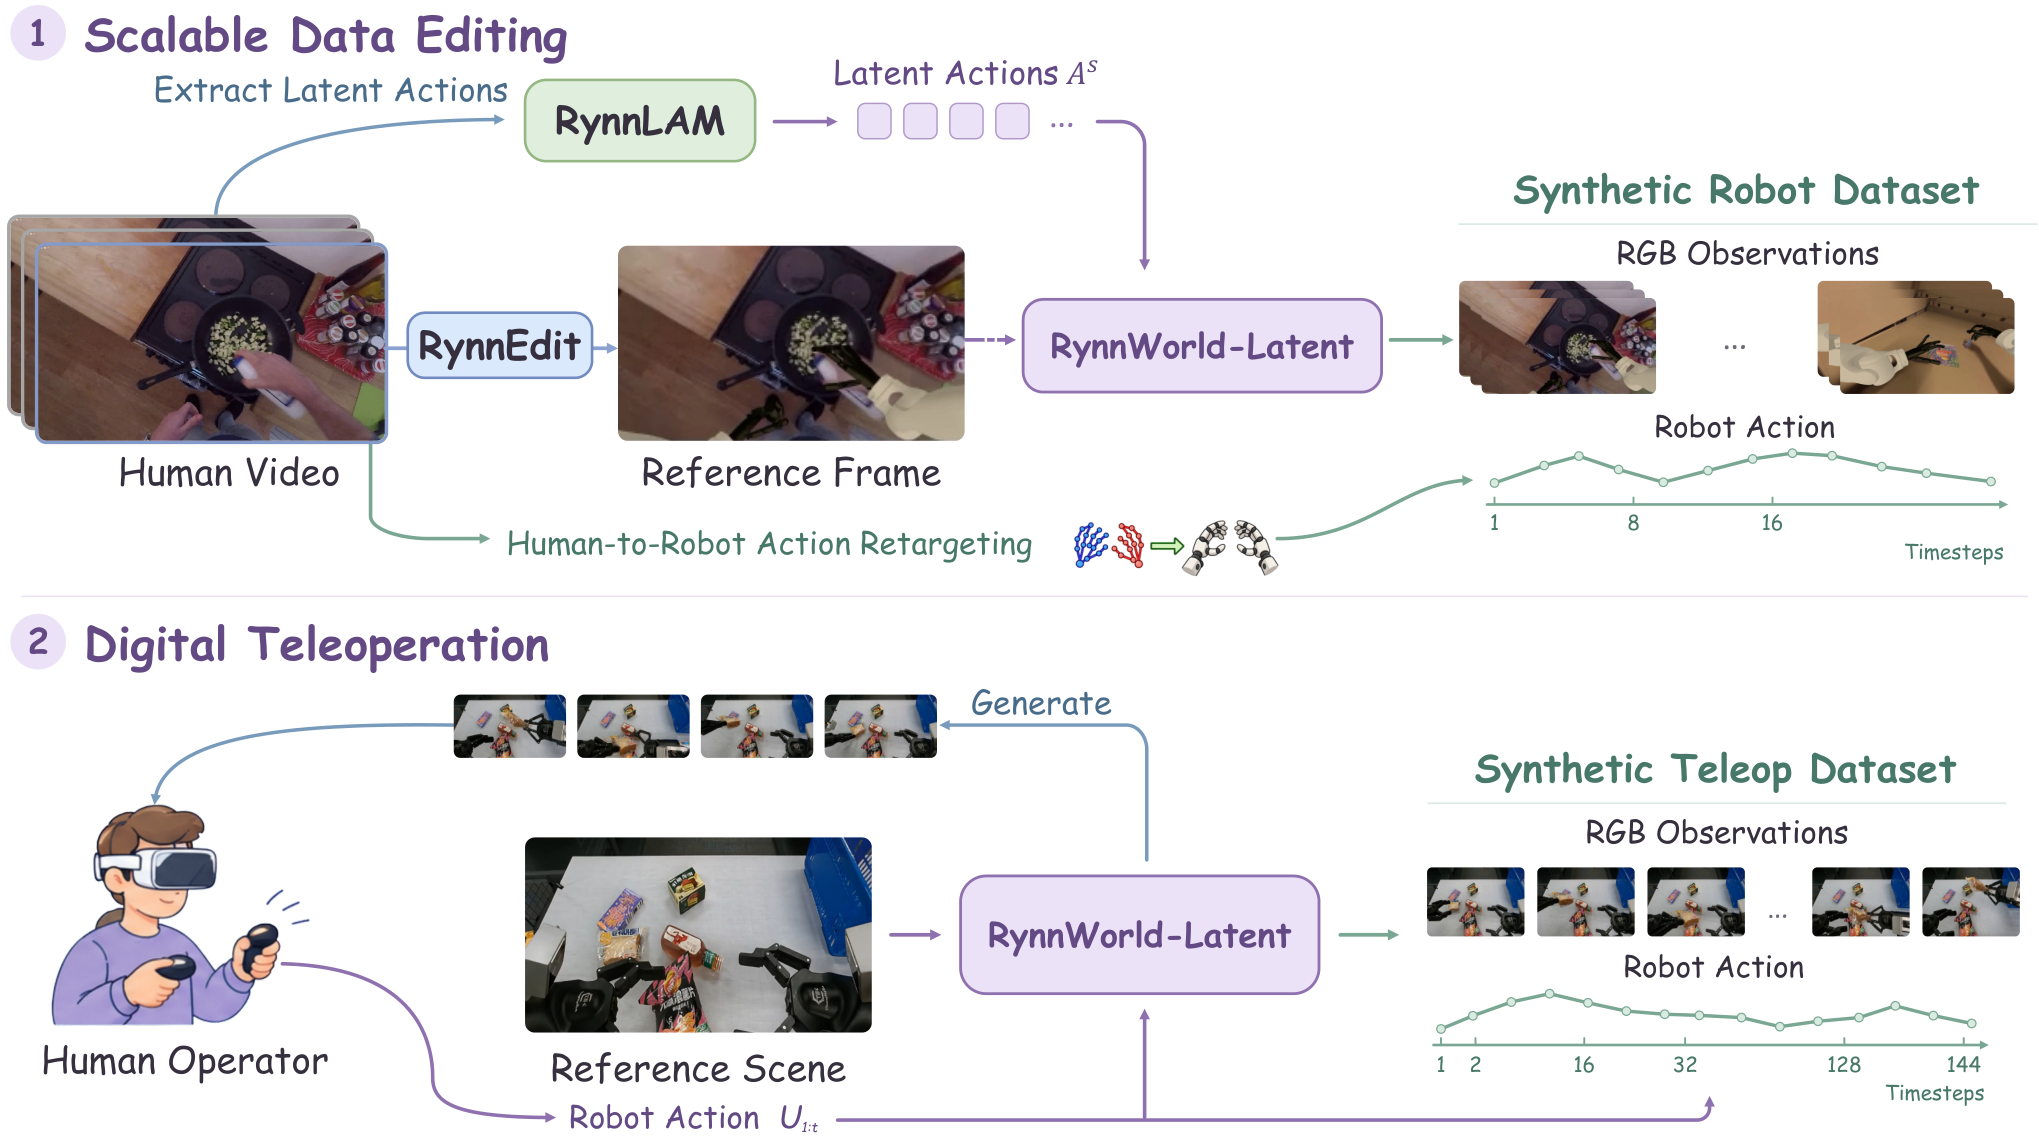
冻结RynnLAM在每4帧间提取608维潜动作,包含操作和相机部分;81帧经VAE形成21个latent,与20个转移一一对应。跨形态预训练不要求原生控制维度相同。
- 2
全局与局部同时注入
全局动作token参与注意力,局部零初始化调制只注入对应未来帧,不动首帧。局部路径初始为恒等,不代表完整模型恒等,因为新动作token仍参与全局注意力。
- 3
两路生成都要筛选
图2上路编辑人类视频首帧并迁移潜动作,IK/重定向给出伪机器人动作;下路直接记录操作者映射后的机器人指令驱动视频。目标机器人仍需后训练,生成片段要过滤关节限制、视觉异常和交互不合理。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据论文预训练为23数据集553.5M帧;实机3850示范、六任务按episode分95/5,评测任务仍出现在训练。移除帧对齐后两平台PSNR分别下降0.72/0.88。 表1、表3与适配协议 ↗
我的解读不是零样本新机器人迁移。官方README仍写32数据集、265M以上帧,与论文版本不一致,本文数字以论文表1为准。
来源证据每实机策略/任务35次;π0.5加合成中训后Steak40→60%、Retrieval45.71→68.57%。LIBERO-Plus上π0提升53.6→79.4,而π0.5仅84.4→84.8。 表4与表6 ↗
我的解读合成训练增加数据和算力,两者未隔离;35次中的两三次成功差异不能当显著提升。纯数字遥操作训练在四任务均低于真实示范。
开放情况与使用许可
官方仓库有训练/推理代码、Apache-2.0及第三方许可说明;Hugging Face有4个权重分片但未给出cardData许可证。代码许可不能代替权重及Cosmos等基础模型许可,完整训练语料与下游评测编排不随仓库提供。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
共享动作接口加下游策略验证比只展示漂亮视频更有价值,部分真实任务确有观察到的收益。
反方 · 哪些结论还不够
潜动作包含外观与相机信息,不是已辨识因果控制;伪动作和生成画面可能错配,公开基线有骨干/数据差异,长期滚动仍需检验。
综合判断
可作为数据增广候选,而不是替代真实示范或物理模拟的已验证方案。
我会先做的验证
未执行的验证方案:匹配训练步数与数据量,以真实重复采样、原始人类转换和生成增强三组比较;人工核验接触/动作同步,并在新物体上记录闭环成功率。