Sandwich-Residuals:只改输入输出,世界模型能适应新环境吗
冻结预测器,用约十万参数与最近转移做测试时修正
该方法在冻结世界模型的输入与输出两侧加小残差,用执行中得到的最近转移更新,随后继续做潜空间规划。它以少量可训练参数取得接近较大适应方案的成绩,但仍依赖冻结表示能看见关键信息,也没有证明参数减少会按比例降低总运行成本。
图解主要方法
图 1 的两层“夹心”如何在不改预测器的情况下修正动力学?
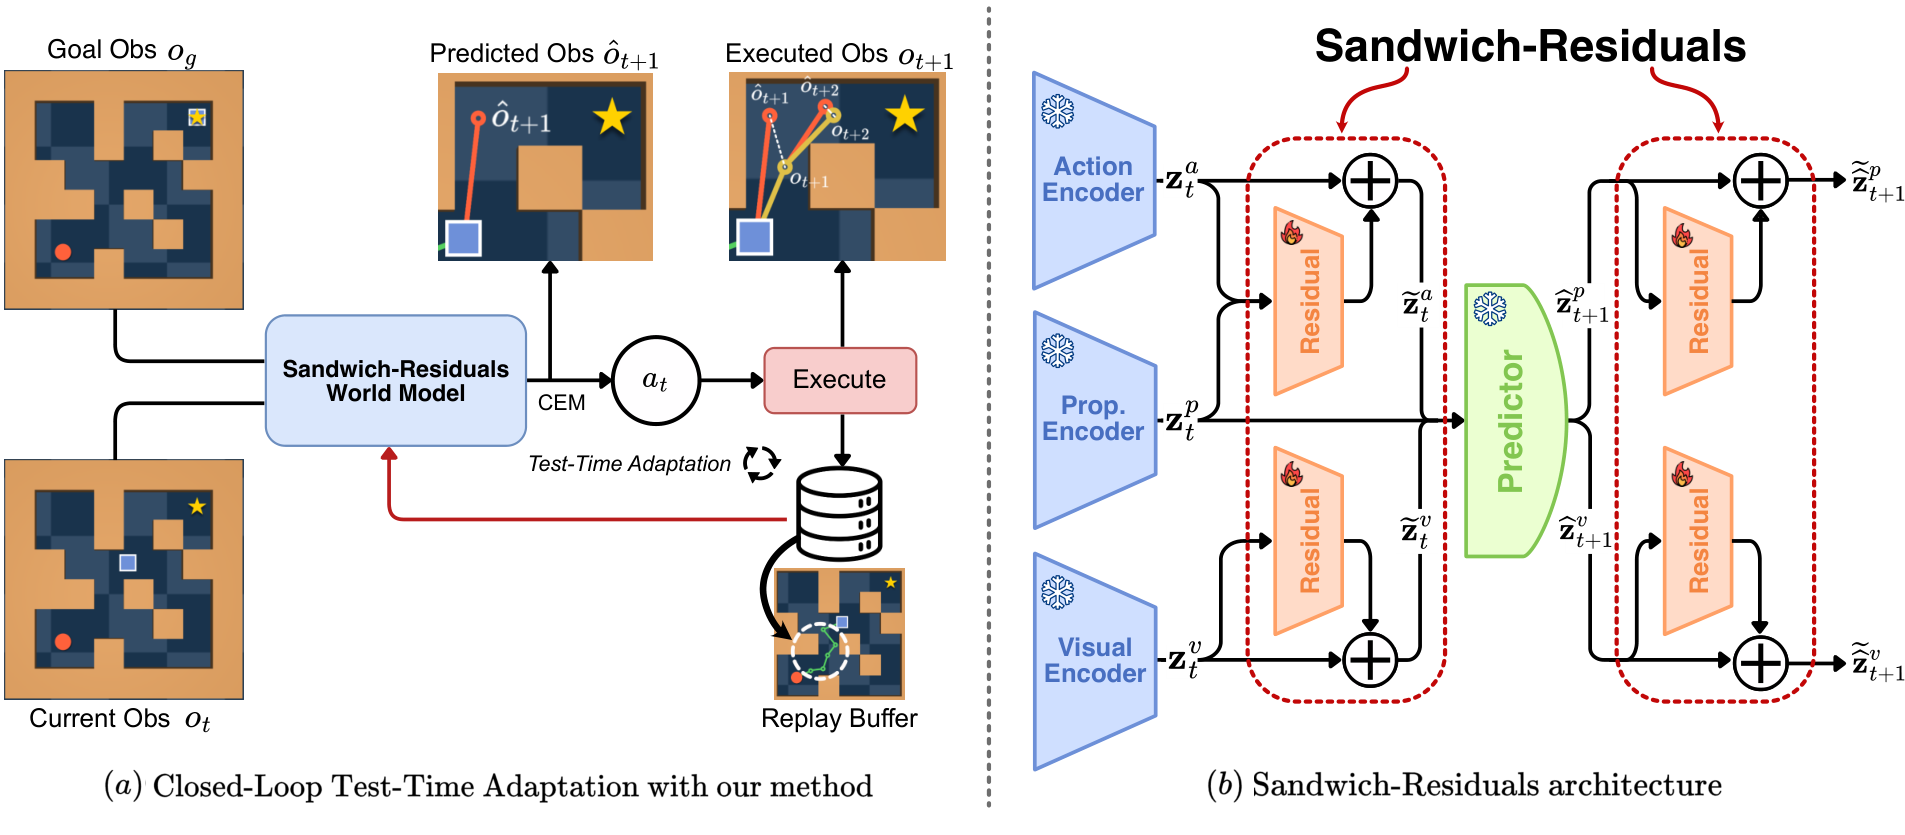
- 1
输入侧同时修正视觉与动作坐标
视觉特征经过 384→64→384 的残差 MLP,动作经过受当前状态条件影响的线性修正。观测、上下文、目标使用一致的视觉变换,避免规划目标和预测状态处在不兼容坐标中。
- 2
冻结主干,但输出再加一次残差
世界模型保持原权重;视觉预测和本体状态分别经轻量残差修正,再递归进入后续想象。输入侧处理感知/动作接口,输出侧处理转移误差,两侧不是简单重复;冻结参数也不代表梯度无需穿过计算图。
- 3
只用刚刚经历的真实转移更新
每段 episode 重置残差,缓存最近五个转移、以 K=3 窗口做潜变量均方误差;目标停止梯度,每次计划执行后做一个 Adam 更新。不使用任务奖励、成功标签或源训练数据,但需要实际在线观测。
- 4
以修正后的模型进行 CEM 规划
采样候选五个动作块、每块五个低层动作,约 200 候选、30 精英、十轮迭代;执行一个块后重看环境。适应和规划交替,而非先在测试集上无限训练再汇报效果。
- 5
把作用范围限制在可表征、相对稳定的变化
主实验组合相机、外观和动力学变化,并测试新的物体形状;单 episode 内变化基本固定、本体观测不变。如果编码器已丢掉关键物体,输出残差难以凭空恢复信息;快速突变环境仍需另验。
实验与证据
以下为作者报告;已阅读 v1 全文及附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【AdaJEPA】21 个主要条件、7 个组合变化、四类任务,50 episodes×5 种子;平均成功率冻结 49.2%,本方法 65.0%,较大适应基线最高 68.2%。 主要结果表 ↗
我的解读约达到最强基线 95% 的成绩比例,不是 95% 绝对成功率。比较使用相同检查点更利于归因。
来源证据【组合变化】相对冻结平均提高 31.5 个百分点,与最强适应差约 0.8±1.4 个百分点。 组合变化实验 ↗
我的解读优势集中在特定变化组合,仍需看各条件与误差条,不能只引用最大差值。
来源证据【Cube/UR5 仿真】四条件、50 episodes×3 种子,平均 60.0% 对 58.7%;无变化条件 60.7% 对 62.7%。 Cube 扩展 ↗
我的解读小幅均值改善也伴随原域退化,不是所有情况下都该启用适应;这些不是 UR5 真机实验。
来源证据【规模及失败】约 99520 可训练参数,对应数百万参数预测器;红色方块条件各方法均低于 15%。 参数统计与讨论 ↗
我的解读少参数不等于按比例省总计算;冻结编码的表示盲点仍可能压过测试时适应。
开放情况与使用许可
作者项目页可访问,展示方法和实验;本次未在所查页面找到正式实现或权重入口,不把项目展示视为代码开源。
LICENSE论文 CC BY 4.0;尚未确认对应软件许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将感知接口与动力学输出分开修正,配合 episode 重置和少量真实转移,提供了明确可复现的在线适应流程。
反方 · 哪些结论还不够
共享冻结表示的盲点、原域退化与缺少真实机器人实验限制了结论;反向和 CEM 仍可能主导时延。
综合判断
是值得尝试的低参数适应方案,验收时应同时看原域损失、每步延迟和失败环境,而不是只看训练参数量。
我会先做的验证
未执行的验证方案:统一规划候选数与墙钟预算,对比仅输入、仅输出、全模型和不适应;加入 episode 中途突变,测恢复时长、遗忘、总时延与逐条件成功率。