SDOB:不重训世界模型,用反馈补偿状态与代价场偏差
前向查询即可估计局部扰动,但补偿通道仍需任务先验
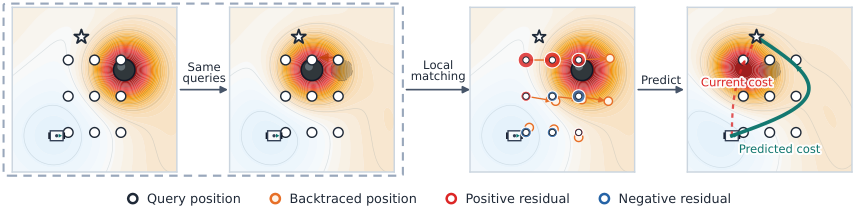
SDOB把部署偏差分为两类:同一动作产生不同状态,以及同一查询位置的代价因环境变化而改变。前者采样任务定义的扰动并匹配真实反馈,后者像光流一样匹配相邻时刻代价场,再把估计插入MPC的状态传播和未来代价查询。
图解主要方法
只提供前向rollout或代价查询的世界模型,如何利用真实反馈补偿局部部署偏差?
- 1
先定义能够补偿什么
任务提供零扰动退化为原模型的扰动rollout接口,如动作偏置或状态残差;反馈只辨识对观测有作用的等效扰动,不必对应唯一真实力。
- 2
用已完成转移估计状态扰动
采样候选,用前向模型重放上一动作,按预测误差、幅值正则和物理约束评分;指数权重归一化得到加权均值,供下一时域使用。
- 3
匹配固定位置的代价变化
在两次感知更新用相同查询位置及邻域比较代价,搜索让旧场后移后最接近新场的局部速度;这估计的是代价图运动,不是必然可识别的物体速度。
- 4
把代价速度传播到未来
按距离与置信度插值,缺邻域时速度设0;沿估计场反向追踪未来查询位置,在当前代价图读值,保持任务目标与其他约束分开。
- 5
冻结模型重新规划或初始校准
MPC用修正状态和代价评估动作,只执行首步再接反馈;但PointWorld实例受速度限制,仅用一次50mm试提校准混合系数,再整段执行。
实验与证据
正文全部公式、算法与五仿真三硬件研究读完,未见另附公开附录;图5核验,官方页面与代码链接实际打开。
来源证据倒立摆正弦偏置1.2sin(1.2t)N·m,20种子SDOB和传统DOB均20/20;扰动RMSE .014比.018,P95约8.23ms。 图表8 ↗
我的解读在解析可逆任务与经典DOB相近,不证明全面优于传统控制。
来源证据八动态障碍两通道SDOB与RMPPI均20/20无碰撞;路径比1.484对1.573,P95 20.77对18.76ms。 图表10 ↗
我的解读路线更短但计算更慢;是完整方案对照,不是两通道独立贡献。
来源证据LeWM Reacher隐藏动作偏置[.30,−.20],SDOB19/20,MPPI0/20,尾误差.030对.427rad。 图表12 ↗
我的解读20任务预筛为无扰动MPPI本来能解,结论限于恢复这个可解子集,非全任务泛化。
来源证据Rocket速度1.5倍,SDOB19/20且0碰撞,MPPI16/20且4碰撞;Landing各方法均20/20触甲板,中心误差7.38对20.49px。 图表15 ↗
我的解读Landing成功定义仅首次触甲板,改进为落点对齐;Rocket余一失败不碰撞,可能超时。
来源证据Reacher、Rocket、Landing基础规划P95约.46、2.12、12.13秒,均超过仿真控制间隔。 Remark 3 ↗
我的解读三任务都暂停模拟器等待计算,因此不是实时闭环世界模型部署证据。
来源证据真实PointWorld20配对试验最终RMSE55.26±14.99→22.61±12.58mm,实际提起287.39→306.60mm,目标300mm。 表3 ↗
我的解读先50mm试提拟合0–1刚体/模型差修正系数,随后无重规划/观测器更新;不是持续在线自适应。
来源证据真实小车代表轨迹9.29秒,其他12.07–14.04秒;双臂示例用AprilTag位置、无额外安全边距。 表2;第5.2节 ↗
我的解读仅代表性演示,未提供足够重复统计支持可靠性或安全认证。
开放情况与使用许可
项目页声明发布导航、倒立摆、LeWM Reacher代码与配置,但官方所链GitHub仓库网页及API在本次检查均404,故当前不标开源;PointWorld等完整实验包也未核实。
LICENSE论文arXiv非独占许可;实现仓库当前不可获取,代码许可未核实;图5仅署名用于必要方法评论。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
各仿真任务共享名义模型、初态、种子、时域与名义rollout预算,报告含观测器的墙钟耗时。
明确披露Reacher任务筛选、视频任务暂停和真实盒子单计划执行。
反方 · 哪些结论还不够
比较的是完整控制器配置,未分别消融两通道和刚体修正先验,不能把全部收益归因采样观测器。
Gibbs加权均值不保证是损失最小解,也不保证多峰可行集上的物理可行性。
代价恒定区和直边界存在不可辨识,新增障碍/多运动/感知边界可能破坏平移近似。
综合判断
是把扰动反馈接入黑箱规划的实用接口设计;现有证据支持任务特定局部校准,尚不支持无需先验、实时通用世界模型自适应。
我会先做的验证
建议实验(尚未执行):固定总墙钟预算,消融状态/代价通道和补偿先验;加入突变、多峰扰动、感知噪声与新障碍,真实连续闭环报告延迟、失败及碰撞区间。