SimVTA:为候选驾驶轨迹配上真正对应的模拟未来
训练时以三维高斯渲染补齐动作后果,推理时只输出轨迹
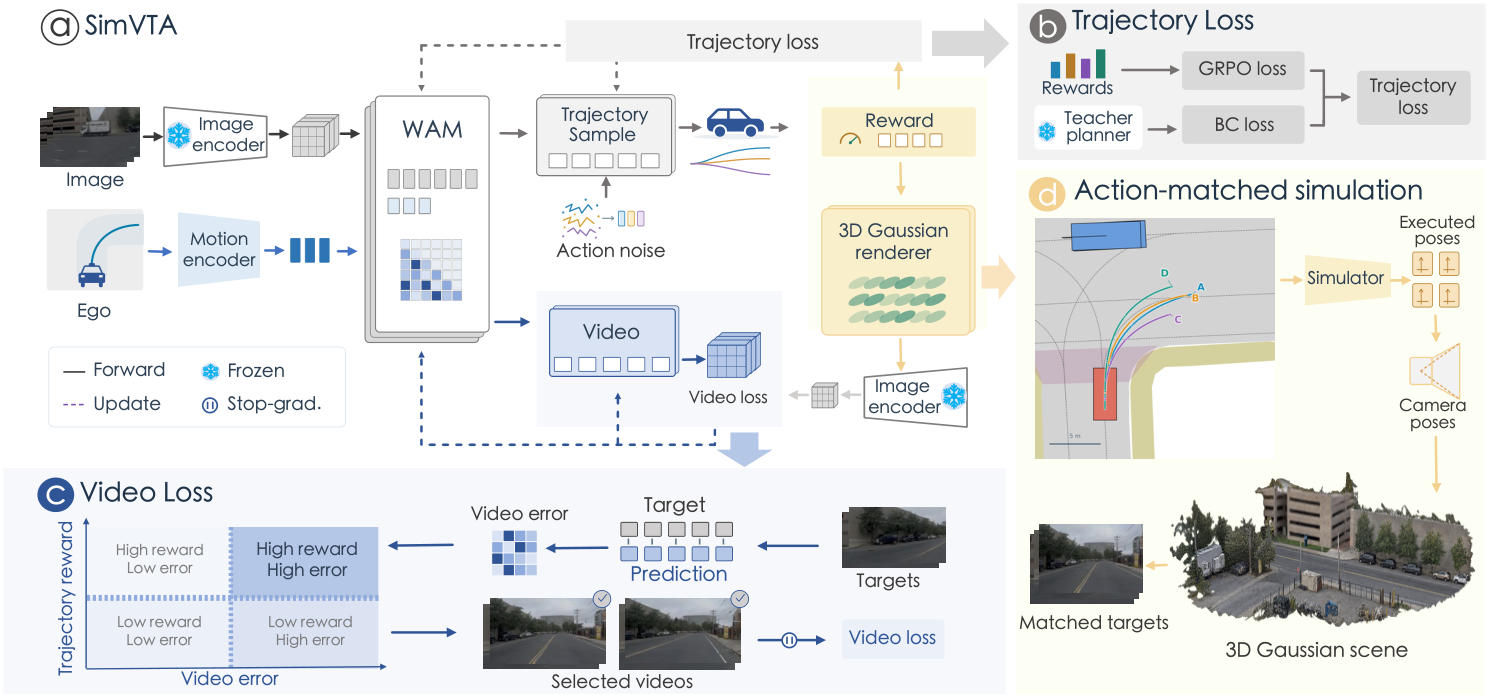
驾驶日志只记录实际走过的一条路,不能给另一条候选轨迹直接套用原视频。SimVTA使用World Engine沿执行后的候选路径渲染监督,再让视频损失更新与规划共享的表示;这种训练监督作用与推理时看视频选路不同。
图解主要方法
训练时以三维高斯渲染补齐动作后果,推理时只输出轨迹
- 1
采样并执行候选轨迹
图2a/b从四帧观测历史生成32条轨迹,每条8个点、覆盖4秒;PDM执行器得到真实执行路径并评分。奖励以碰撞和可行驶区为乘法项,进度、TTC、舒适权重10/5/2,视频误差不进入轨迹优势。
- 2
按同一路径渲染和条件预测
图2d沿执行路径设相机,3DGS生成目标视频,模型也用该路径作运动条件。仅为满足执行、位姿和安全条件的高奖励候选最多渲染4条;这些筛选不删除用于轨迹学习的其余候选。
- 3
挑出高奖励但预测困难的未来
图2c先在已渲染候选中计算教师强制误差,帧重建占0.7、时间变化占0.3,高于场景均值者进入Q2。误差在固定流时刻0.5计算并停止梯度;训练则重新采样噪声与流时刻,每次循环选一个未来帧。高误差也可能来自渲染缺陷。
- 4
联合更新共享表示,部署去掉视频生成
视频流匹配与轨迹组相对学习、冻结初始TrajDiT的行为克隆正则联合训练,视频梯度进入共享表示时缩放0.2。图2虚线区分更新路径;部署直接预测轨迹,无模拟器调用、未来视频生成或视频重排序。附录轨迹目标无新旧策略概率比,不能直接套标准PPO公式。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据16张H20,单GPU batch4,bf16、ZeRO-2与CPU offload,10步轨迹去噪;视频和BC损失权重均0.1。 附录A、表11 ↗
我的解读推理移除视频开销不等于训练便宜,在线渲染、误差评分与视频更新都要计费。
来源证据适配Epona初始化86.2 PDMS,轨迹学习89.1±0.1,只更新视频头仍89.1;允许视频梯度进共享编码器91.3±0.1。 表5与附录D多种子 ↗
我的解读全流程+5.1分,视频监督相对轨迹学习额外+2.2分,应分开归因。
来源证据同场景打乱轨迹视频配对降到83.1;固定离线缓存90.4,在线91.3;渲染预算4增至8为91.2。 附录D、表12–14 ↗
我的解读证据支持配对与在线更新,不支持渲染越多越好。混合高低奖励对照还改变安全优势处理,不能视为单因素比较。
来源证据NAVSIM v2 EPDMS85.0→88.2,但红绿灯99.7→99.0、扩展舒适67.6→60.0。HUGSIM平均HD38.8,极端场景27.2低于DrivoR32.5;FID/FVD在日志真实轨迹上评估。 附录E–G ↗
我的解读总体分提升不能掩盖子项退化;日志视角画质未验证任意新视角,非反应式交通也不能证明真实交互安全。
开放情况与使用许可
官方仓库当前只有README和results,代码与检查点仍列待发布;README声明仓库内容Apache-2.0,不能据此宣称实现或权重已开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
用外部几何渲染监督候选动作后果,比拿模型自身想象当真值更可检验;共享编码器和配对打乱消融明确了收益发生的位置。
反方 · 哪些结论还不够
遮挡与未观测区域限制新路径渲染,高误差筛选可能放大伪影;只验证Epona主干,尚缺反应式交通和真实道路测试,也缺完整训练墙钟成本。
综合判断
值得借鉴的是动作与未来监督的对应关系。它是训练期改善规划表示的证据,不是通过视频想象完成在线决策的实车系统。
我会先做的验证
未执行的验证方案:在相同总GPU小时而不只是相同渲染上限下比较在线与缓存方案;引入新视角质量过滤、反应式交通和初始化闭环对照,分别报告碰撞、舒适、进度及置信区间。