SkeLAM:用骨架把运动意图从视频残差中拆出来
可解释动作潜变量,能否让机器人视频预测更可迁移?
把潜在动作分成骨架约束的运动部分和补充视觉残差,再适配机器人动作驱动视频模型。DROID预测改善,但另一机器人域有退步,策略评估成功样本仅九次。
图解主要方法
可解释动作潜变量,能否让机器人视频预测更可迁移?
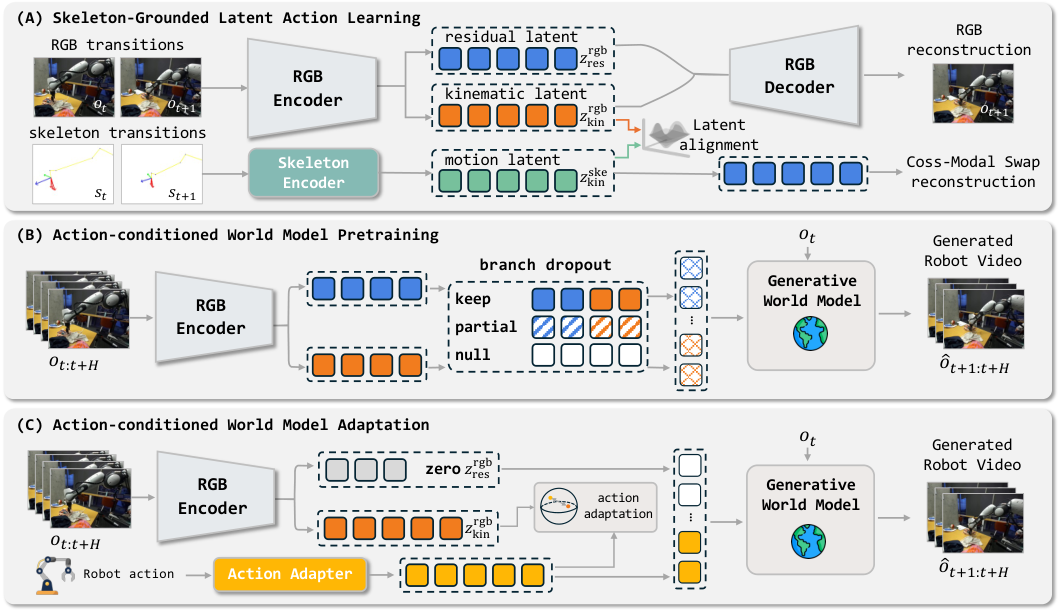
- 1
建立骨架教师和双潜变量
图1从RGB编码32维运动潜变量与32维残差;先训练骨架重建教师再冻结,利用骨架对齐和余弦监督约束运动分量,使其比纯像素动作更可解释。
- 2
交换运动分量以限制信息混入
用骨架目标替换运动分量、保留视觉残差重建视频,同时施加方差和交叉协方差正则。该设计鼓励解耦,却不是统计独立性的证明,残差仍可能携带运动信息。
- 3
用双分支条件训练视频模型
Cosmos-Predict2.5-2B采用独立投影和存在掩码,随机丢弃完整条件分支;机器人动作差通过7→256→256→32适配。世界模型整体微调,残差条件随训练课程下降,8k步后为0。
- 4
部署仅输入动作条件
推理时残差置0,不读未来视频;DROID评估每段13帧、480×640、15fps约0.8秒、35采样步。视频预测与策略筛选主要依赖记录的动作序列,不等于闭环机器人执行。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据400段视频中轨迹指标有效样本SkeLAM326、DreamDojo325;ADE从51.11降到41.15约19.5%,LPIPS0.1473到0.131约11.1%。F1为0.5465,低于Ctrl的0.5888。 DROID主结果 ↗
我的解读有效子集略不同,视频指标还包含条件帧;平均改善需与匹配轨迹子集和预测帧单独评分一起看。
来源证据AgiBot400段、800条机械臂轨迹上,相对DreamDojo的ADE19.55→21.10、LPIPS0.0889→0.1049,均退步。 跨域反例 ↗
我的解读骨架解释性并不自动保证跨域预测更好,不能只选择DROID结果概括通用优势。
来源证据RoboArena7个策略、15个session共105次,真实成功仅9次;recall33.33%即找出3/9,balanced accuracy63.02%、MCC0.2483。策略排名Spearman0.5347、Pearson0.6091仅基于7点,MAE4.76对7.62个百分点。 策略评估样本 ↗
我的解读少数成功样本和七个排名点使估计不稳;记录动作开环回放不能证明该模型能够闭环选出安全策略。
来源证据论文展示两个人类视频条件迁移的定性例子,没有对应真实机器人执行及任务完成率。 人类动作迁移 ↗
我的解读这是可视化可行性证据,不能提升为已经验证的跨形态机器人技能迁移。
开放情况与使用许可
已核对作者项目与论文,项目页未发现可核验的官方代码、模型卡和权重发布链接;本文不标为开源实现。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把可解释骨架与残差显式拆分,提供了比不可解释潜在动作更容易检查的中间表示。
反方 · 哪些结论还不够
跨域退步、有效样本不完全匹配、极少成功事件与开环评估限制了世界模型用于策略评选的可靠性。
综合判断
值得研究运动表示的可迁移性;当前更像视频预测与离线评估方法,尚不足以承担真实策略验收。
我会先做的验证
未执行的验证方案:扩大成功和失败轨迹数,固定相同有效样本并排除条件帧;做跨相机/跨机器人测试,再用受保护的闭环执行检验排名是否预测真实成功。