SmolWAM:世界动作模型的速度瓶颈也藏在输入接口里
压缩视觉、文本和动作接口后,单次前向同时输出动作与未来图像
从 Cosmos Policy 蒸馏出约0.88B参数的世界动作模型,保留未来图像预测能力,在A100上将观测到16步动作块的延迟压至57毫秒。预测画面没有反馈到动作决策中,因此不能将其描述为基于想象进行规划。
图解主要方法
压缩视觉、文本和动作接口后,单次前向同时输出动作与未来图像
- 1
压缩观测与文本入口
用单帧Wan VAE与适配器替换33帧视频编码,用缓存的BERT上下文替换大文本模型。零填充到512个位置仍影响softmax分母,是注意力吸收项;直接截短文本序列会破坏行为,不能把填充视为无效计算直接删掉。
- 2
保留关键层与状态条件动作查询
教师28块保留前3与后9块,动作槽从196压到28个查询;删除未来状态、价值等槽,序列1764降到1008。实际代码保留空白槽与四幅图像槽,动作块16步、动作7维。逐层近似恒等不意味着可以同时删除全部这些层。
- 3
分阶段蒸馏后单步生成
先在完整接口训练1000步,再以紧凑接口训练4000步;使用固定噪声、动作真值与教师动作、未来潜变量真值与教师目标。一次流匹配前向同时恢复动作及未来潜变量;执行完整16步后重新观测,并非每57毫秒闭环纠正一次。
- 4
把未来预测当作独立可观察输出
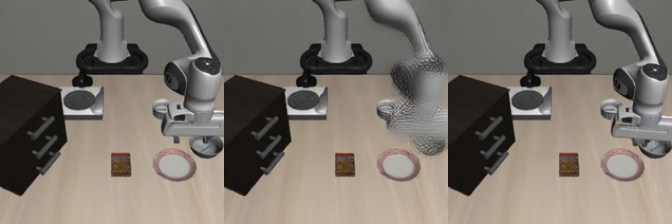
图2从左到右是当前、预测和真实未来,预测呈现明显模糊。动作不读取已去噪的未来结果;世界预测头是否提升控制需要另做消融,论文计划的去头实验并未执行。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据batch=1、bf16、A100 SXM4 40GB、双方均缓存文本:57ms对624ms,峰值2.36对7.55GiB;57ms中主干37、VAE13、预处理7。 主实验与附录硬件条件 ↗
我的解读是特定服务器GPU的端到端动作块延迟,不能改写为边缘设备实测,也不能全部归因于剪枝。
来源证据40任务各10次,学生382/400=95.5%,Wilson区间93.0–97.1%;教师393/400=98.2%,但来自较早L4评估流程。长程子集89%对97%。 LIBERO完整评估 ↗
我的解读总成功率接近但不完全配对;长程下降比整体差异明显,60次筛选实验不能替代400次结果。
来源证据96个留出上下文,潜变量L1为0.101,复制当前帧0.133;RAFT EPE 1.43对1.63。但LPIPS为0.128,劣于复制基线0.115。 世界预测评估 ↗
我的解读潜变量和运动指标改善不代表感知质量全面提高,图2模糊与LPIPS结果必须一起读。
来源证据公开训练、推理和评估代码,模型库含model.safetensors。模拟INT8在bf16核上测得存储减小,峰值显存不变;六项计划消融未运行。 附录与实际仓库 ↗
我的解读不能声称有真实INT8加速或已证明世界头带来控制收益。
开放情况与使用许可
已核实仓库有实现、训练与评估文件,Hugging Face含权重。代码Apache-2.0;权重NVIDIA One-Way Noncommercial License,研究教育用途限制,应分别审查。
LICENSE论文 CC BY 4.0;代码 Apache-2.0;权重 NVIDIA 非商业许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
对接口、序列长度、去噪步数和网络深度联合优化,比只剪模型更接近部署实际;保留的预测输出使动作与未来可以一起审查。
反方 · 哪些结论还不够
模拟机器人结果不能替代真实机器人或边缘延迟实测;未来图像不参与规划,长程成功率下降,世界头因果贡献未验证。代码Apache-2.0,但继承Cosmos的模型权重受NVIDIA非商业许可约束。
综合判断
可作为轻量世界动作模型的工程参考。适用边界是仿真、固定动作块和指定硬件,不应包装成已完成边缘自主规划的通用机器人模型。
我会先做的验证
未执行的验证方案:用同一GPU、同一预处理与400次种子重测教师和学生;加入去世界头、去蒸馏和短动作块的配对消融;在目标边缘设备上分别记录视觉编码、主干、控制频率及热降频。