SolarRenderer:从灰盒结构到四步视频渲染
对齐每帧结构并蒸馏加速,能否让不同3D工具共用一个生成渲染器?
SolarRenderer以灰盒、深度、骨架或语义视频为结构条件,用冻结MiniMax-H3 33B加控制/加速LoRA生成外观。它对预演和资产展示管线有用,但输出仍是视频,不会自动生成可重光照材质或UV。四步全片生成与多GPU实时流式是两种配置,不能混成单卡实时。
图解主要方法
对齐每帧结构并蒸馏加速,能否让不同3D工具共用一个生成渲染器?
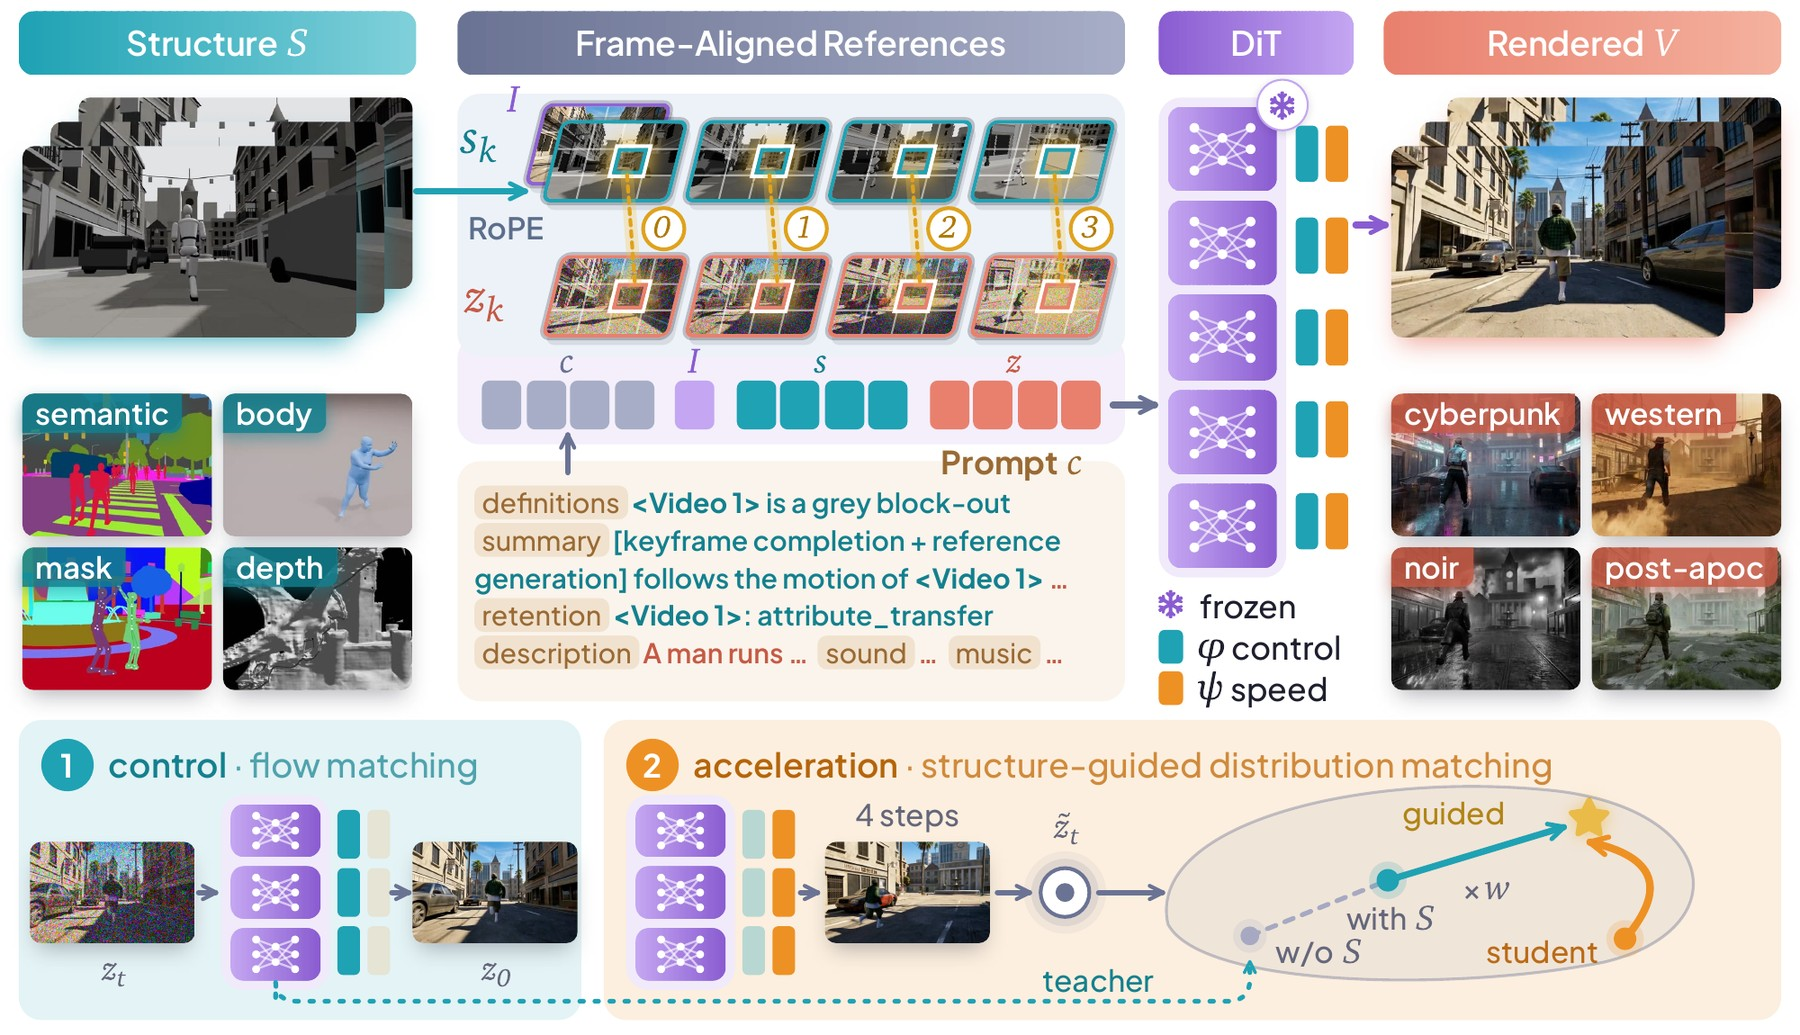
- 1
1 · 逐帧对齐结构与目标token
原图左中把结构潜帧放进底座原生参考通道,使用与目标帧相同的RoPE时空坐标;参考近干净时间与目标含噪时间区分两者。无需为每种结构增加专用分支,但提示会用固定文字说明结构约束什么、哪些外观不应照抄。
- 2
2 · 先学习控制,再冻结控制
图中青色控制LoRA通过flow matching学习结构遵循,秩384,作用于注意力和前馈投影,底座始终冻结。训练语料约136K片段,只有对齐可靠的来源提供结构;较差结构的WildWorld、OmniWorld只作外观数据。
- 3
3 · 用结构引导教师训练加速LoRA
橙色分支从DMAD四步LoRA起步,扩展至秩384;教师比较有结构和移除结构两次预测,以w=1.5外推结构贡献。只更新加速器,避免加速目标改变已学控制;普通w=1分布匹配反而可能把学生拉回模糊教师。
- 4
4 · 流式版重新学习因果上下文
每块最多5个潜帧,只看当前结构与过去5块,先teacher forcing训练因果控制,再用学生自身rollout训练因果加速;配合固定窗口KV与流式VAE输出。它不是把全片模型直接切块,且外观和首帧颜色保持会付出代价。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据53条同分布留出片段;泛化208案例来自57结构视频、16种表示,其中11种训练未见。四步模型泛化整体Elo1441与LynnReal-Omni并列;未见子集74例整体1403对1409略低,结构1360对1275更好。 主表与泛化协议 ↗
我的解读应突出陌生结构遵循,而非声称所有维度第一;多数主结果由Gemini成对评审,人工研究只报告方向一致,规模不够详尽。
来源证据158帧1344×768视频,论文单GPU四步约209秒,50步2562秒,约12.3倍;实时流式最高28FPS,公开Reactor路径明确为四张B200验证。 速度与工程发布 ↗
我的解读相对加速仍不等于普通单卡实时;不能把低显存ComfyUI配置和四B200吞吐拼成同一配置。
来源证据共享RoPE半分辨率总分66.2对分离66.0;去错配数据66.5。数据缩到1/10的变化小于换随机种子。DMAD引导后控制改善,但稳定性、首帧和自动总分可能下降。 消融与自动指标 ↗
我的解读收益依赖配对质量与指标权重;Elo只能在同一拟合比较组内比较,不能跨表直接减分。
开放情况与使用许可
代码含训练、推理和评估实现,Apache-2.0;HF有4个LoRA safetensors。权重遵循MiniMax H3 Community License,含地域限制及商业条件,不等同Apache。训练索引136289条、可分发视频57738条;数据按来源分别许可,非全量开放。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
一个结构接口对接多种引擎输出,能减少预演、动画与生成视频之间重复做控制适配的成本,适合3D资产展示阶段。
反方 · 哪些结论还不够
没有输出几何、UV、PBR、去光照或可重光照纹理;外观可由先验补全并漂移。数据和基线分辨率不同,模型评审及小样本人评有限;流式性能依赖高端多卡。
综合判断
是资产管线的生成式渲染层,不是取代物理渲染、材质制作和几何交付的一体化方案。
我会先做的验证
未执行的验证方案:用相同资产导出灰盒、法线、深度和线框,固定相机与动作检验轮廓/接缝/身份保持;切换灯光和材质时检查是否只改外观,并独立测单卡延迟与流式首块延迟。