空间语言建模:用同一组坐标词预测动作与推物后的状态
Push-T中的共享序列监督,尚不是通用空间智能或显式规划
这项工作把推杆、T形物块、目标轮廓和动作目的地离散成同一128×128网格的坐标词,再用手写语法组织为序列。随机交互先训练动作条件下的状态预测,专家示范再联合监督动作和状态;执行时只解码动作,真实观测持续更新历史。在一个平面推物任务上,状态监督与随机交互预训练均带来真机成功率提升,但标定、已知几何和对照配置限制了泛化结论。
图解主要方法
同一坐标词表与下一token目标,能否让非专家交互中的状态转移帮助目标导向控制?
- 1
将几何和动作放进共享离散词表
128×128网格共16,384坐标token,每格一个ID而非分别生成x/y;实体轮廓按固定顺序排序,语义词state、pusher、tblock、goal、move-to区分角色。训练输入是轮廓,评估覆盖率却使用填充区域。
- 2
用任务语法组织序列
STATE含推杆、物块和目标轮廓;MOVE_TO含命令词、目的坐标以及可选下一状态。语法规定格式,模型学习坐标内容;新任务语法不是自动发现的。
- 3
先学习随机动作的结果,再学专家行为
随机预训练仅屏蔽move-to后目标坐标的损失,该坐标仍留在上下文;命令标记与状态仍监督。专家阶段所有位置都监督,后续状态块以30%概率独立保留,形成动作与状态交错和连续动作子序列。
- 4
控制与状态滚动采用不同解码
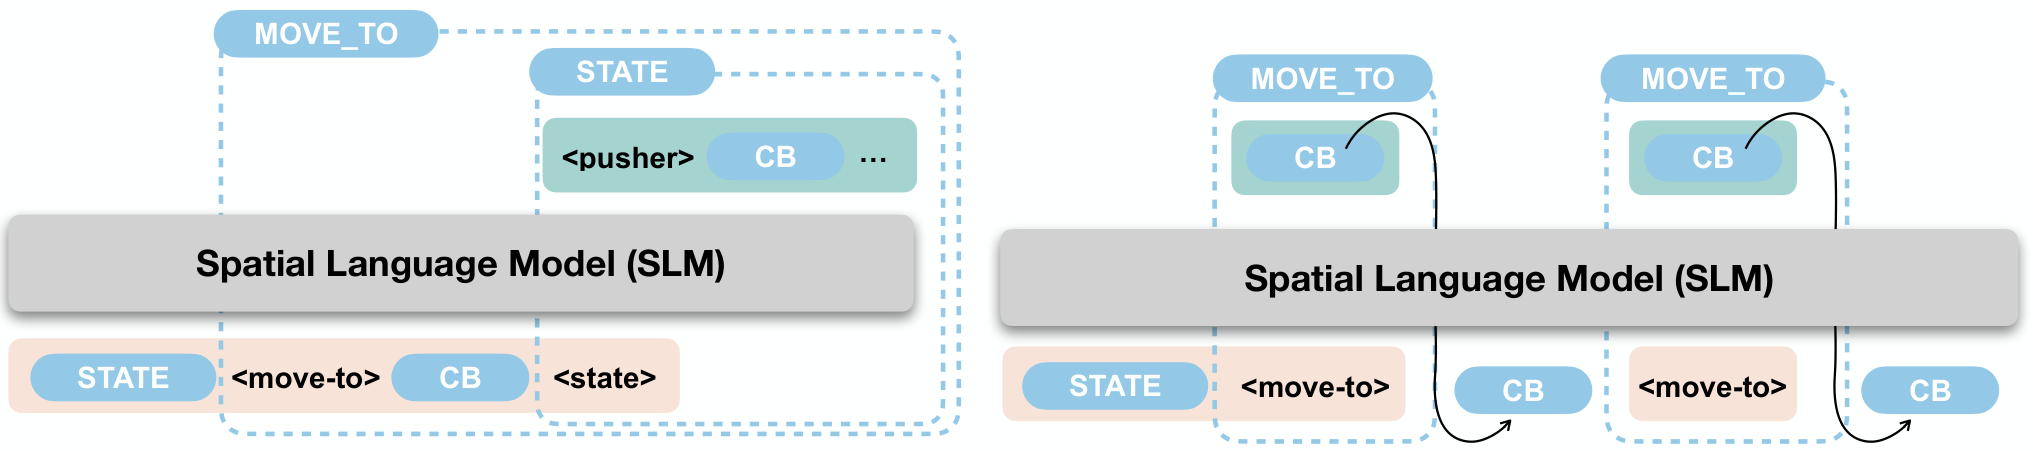
三帧观察历史作前缀,语法状态机排除未来STATE,执行前20个预测目标再用新观测更新。另一个预测模式接收给定动作,用自身先前预测状态滚动;这不是控制过程中的必经步骤。
实验与证据
正文、附录A–C及基线实现细节全部已读,视觉检查图3;核对arXiv首发与许可,未独立复现。
来源证据作者报告462M Qwen2架构从零训练,7层、宽1536、24头、RoPE,最大上下文13,000;四张A100约5小时。 4.1;附录A ↗
我的解读采用架构不意味着使用Qwen语言预训练;只给总训练描述,不能推定所有对照计算预算相同。
来源证据仿真200专家示范、200epoch,每5epoch评估;Max0.95、Avg0.93,DP-C为0.95/0.91。 4.1–4.2表2 ↗
我的解读Max为跨checkpoint最高平均覆盖,Avg为末10checkpoint平均覆盖;都不是95%/93%任务成功率,也未完全匹配输入表示。
来源证据真机40成功示范、20随机episode共5,229帧;每方法20初态,覆盖≥0.95算成功,否则300步截止。 4.1 ↗
我的解读随机交互是额外数据,初态手工匹配而非严格同一重置;任务步对应移动一次,非固定物理秒数。
来源证据真机完整模型SR0.80、Max0.95;DP-Coord0.45/0.89,DP-Tag0.50/0.89,ACT0.65/0.86。 表2;式4 ↗
我的解读这里Max是每次试验峰值覆盖率的均值,与仿真同名指标不同;不等于末态平均质量。
来源证据动作单训SR0.05、联合无预训0.65、完整0.80;相应Max0.67/0.92/0.95。 4.2 ↗
我的解读两个消融支持逐步设计,但监督token数量与有效训练信号都变化,不能称纯架构对照或一般因果定理。
来源证据给定人工标注动作,十步预测覆盖从0.98降到0.92、IoU从0.96到0.85。 图5 ↗
我的解读是与执行相同动作的模拟器比较;未充分报告测试rollout数量或置信区间,十个任务步也不是十秒,更不能外推长时稳定。
来源证据A100约7,000token/s预填充、800token/s解码,20动作40输出词约0.05秒。 4.2 ↗
我的解读只是按吞吐估算解码,未含完整前缀、传感、解析通信与物理执行,不能直接写端到端20Hz。
来源证据DP输入轮廓填充K100或12个Tag角点,预测16执行8;ACT轮廓token含padding mask,预测16执行8。 附录C.1 ↗
我的解读本模型三帧/20步,DP两帧/8步,ACT一帧/8步;这些重要条件会影响公平比较。
开放情况与使用许可
所读论文正文与arXiv摘要未提供研究代码、权重或数据下载链接;检索未确认官方实现,不能把论文公开视作开源。
LICENSEarXiv非独占分发许可;必要引用作者图3用于解释两种解码模式,注明图号及来源,不代表通用再分发授权。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
同为不使用随机预训练,动作单训成功率5%,加入状态序列65%,支持该设定的辅助状态监督。
在联合训练基础上加20段随机交互,65%→80%,支持利用非专家转移数据的潜力。
反方 · 哪些结论还不够
每方法真机仅20次,起始姿态手工尽量匹配;无多训练seed或显著性检验,80%不能直接外推稳定部署成功率。
完整模型比基线多随机交互且用三帧历史,DP两帧、ACT一帧,执行20步对8步,不能将差异全部归自回归架构。
基线适配细节中DP-Coord哨兵填充无显式mask;输入公式也未显式列出目标几何,公平性需进一步核查。
综合判断
是一个范围清晰的几何序列建模概念验证;最值得复现的是联合状态监督与动作条件随机预训练,不是宣称语言模型已经具备一般三维物理理解。
我会先做的验证
建议实验(尚未执行):统一三帧历史、目标表示、20步执行块、随机交互预算和训练算力,给坐标基线加入正确padding mask;跨训练seed和自动重置初态比较成功差,并测未见形状、摩擦变化和长时状态误差。