Stateful Harness:先执行规则,再生成世界画面
相同画面与动作,如何因隐藏状态不同而得到不同结局
系统把库存、生命值等隐藏状态放在显式账本中,由固定程序决定动作后果,再编译成视频生成指令。WorldState-Bench使用50组反事实双胞胎:首帧和动作相同,隐藏值不同。它主要检验渲染结果是否遵守已知规则,而不是学习未知物理规律。
图解主要方法
相同画面与动作,如何因隐藏状态不同而得到不同结局
- 1
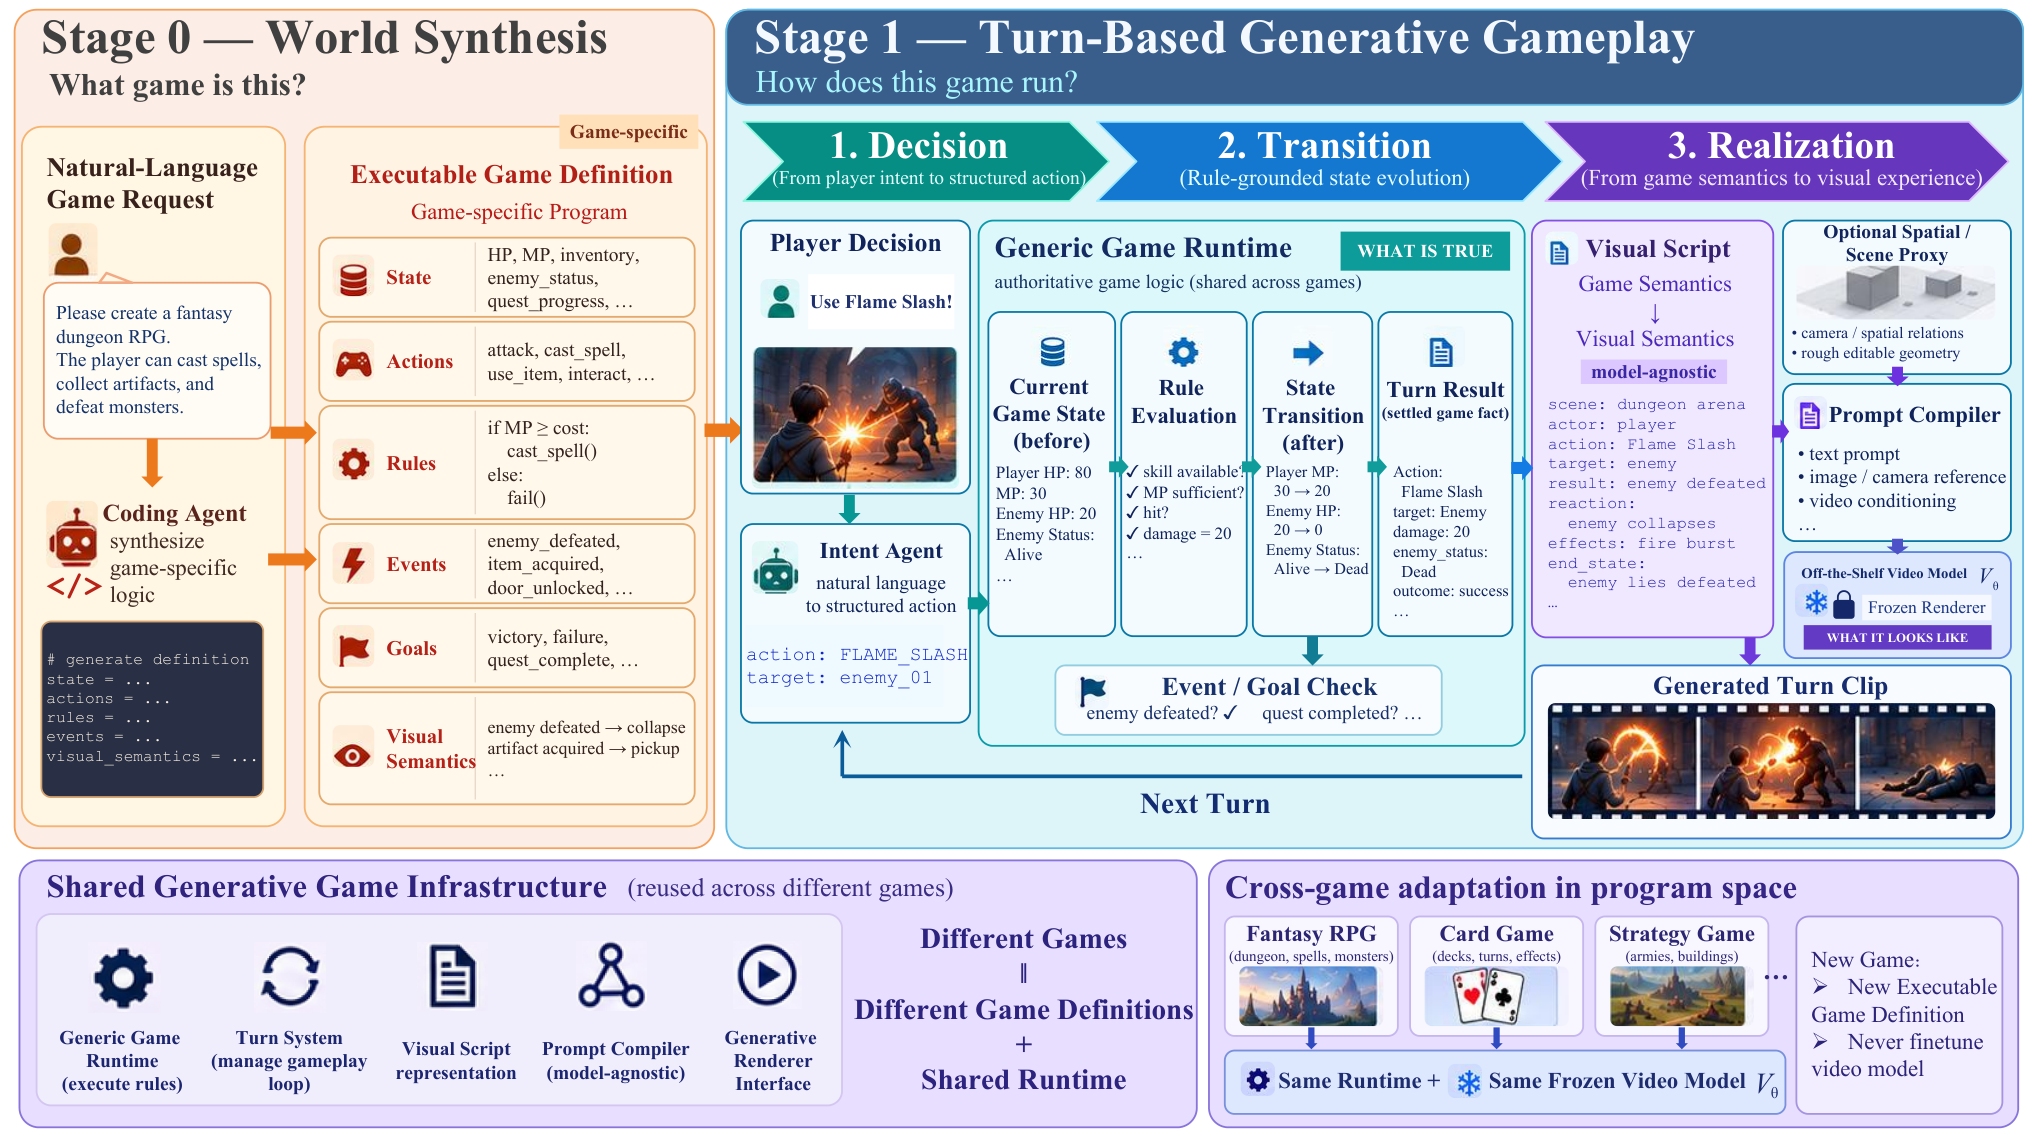
图3 Stage 0:建立并冻结规则
编码代理把世界描述转为状态、动作、guard/effect规则、事件与目标。几何模型从图像构建带标签的粗长方体clay场景;语义账本与空间场景可更新,但回合内规则定义保持不变。
- 2
图3 Transition:动作先在程序中结算
运行时检查资源和规则,计算临时状态、空间编辑与事件;可选语言模型只能在允许集合内补充对话。schema校验、限值、重试和回退约束输出,不能让渲染结果反过来推翻已结算规则。
- 3
图3 Realization:编译语义与空间参考
VisualScript固定排列角色、动作、反应、结局与镜头,将确定结果送给冻结视频模型。复杂空间引导可用Blender粗模型预览,首帧或上回合末帧作外观锚点;必须说明预览仅供布局,避免生成黏土外观。
- 4
观察视频后有约束地回写
VLM提出可见状态更新,只有与固定规则兼容的内容才写回;矛盾画面记为渲染不一致。后续状态因此可以受视觉反馈影响,但重放需保存接受的观察和模型版本,固定权重不保证像素确定性。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据50对、21主题、49隐藏变量,每条件一次生成;MiniMax-H3 PairFollow从Rule-only32%到显式结局64%,harness92%,PairStrict90%。主测试harness使用文本与首帧,空间预览的收益主要另在WBench检验。 WorldState-Bench表4 ↗
我的解读不能将60点提升全归因3D预览,也不能将规则正确称作渲染绝对正确;50对及特定主题限制泛化。
来源证据102段盲审视频每段三人,judge两问题一致率91.2%/86.3%;25对与四基线强制偏好比较,98%比较选择harness。外部WBench全套74.2到77.9,但一致性83.8降至77.8。 人审与消融 ↗
我的解读偏好对照采用Rule-only基线,未隔离所有编译与结算组件;更遵守目标不等于所有视频质量都提高。
来源证据展示15、29、11回合三种游戏;评价使用8张A800 80GB,空间处理离线。默认渲染失败可复用旧锚点且仍计回合执行。 多回合与复现边界 ↗
我的解读长回合主要为示例,缺少系统性跨回合误差统计;程序账本可能正确而画面未显示对应事件,必须分别监控。
开放情况与使用许可
2026-10-21核验GitHub有runtime、compiler、renderer及评价模块,LICENSE为Apache-2.0;HF有cases.parquet与图像,数据卡标注图像受FLUX.2-dev非商业条款约束。外部MiniMax权重另有社区许可,不能把代码许可扩展到全部模型数据。论文图3为CC BY 4.0。
LICENSECC BY 4.0(论文及原图)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
用程序承担必须精确的状态转换,再用生成模型承担外观,为可控交互内容提供了清晰的职责分配。
反方 · 哪些结论还不够
规则和预期答案同源,测的是已指定规则的视觉实现;粗盒场景、单主体空间流程、离线成本与有限反事实主题限制开放世界应用。组合消融不足以独立解释每个组件贡献。
综合判断
更接近可编程生成式交互系统,不能据此宣称视频模型学会通用世界动力学。
我会先做的验证
未执行的验证方案:增加未见规则组合、长程回退和渲染失败注入;分别核对账本、画面、观察回写和任务目标,使用同prompt同参考消融,并记录延迟及每回合费用。