StateCraft:把可更新的抽象状态交给视频模型渲染
只记旧画面,怎样处理镜头之外已被动作改变的内容?
StateCraft 用语言模型维护视图与元素组成的显式状态图,视频模型据此生成当前界面。以文件管理器为主场景,它改善重复访问时的内容一致性,并支持直接编辑隐藏状态;其结果依赖预定义结构和首次访问提示,尚不是自主发现世界规则的通用模拟器。
图解主要方法
只记旧画面,怎样处理镜头之外已被动作改变的内容?
- 1
维护图而不是仅检索旧帧
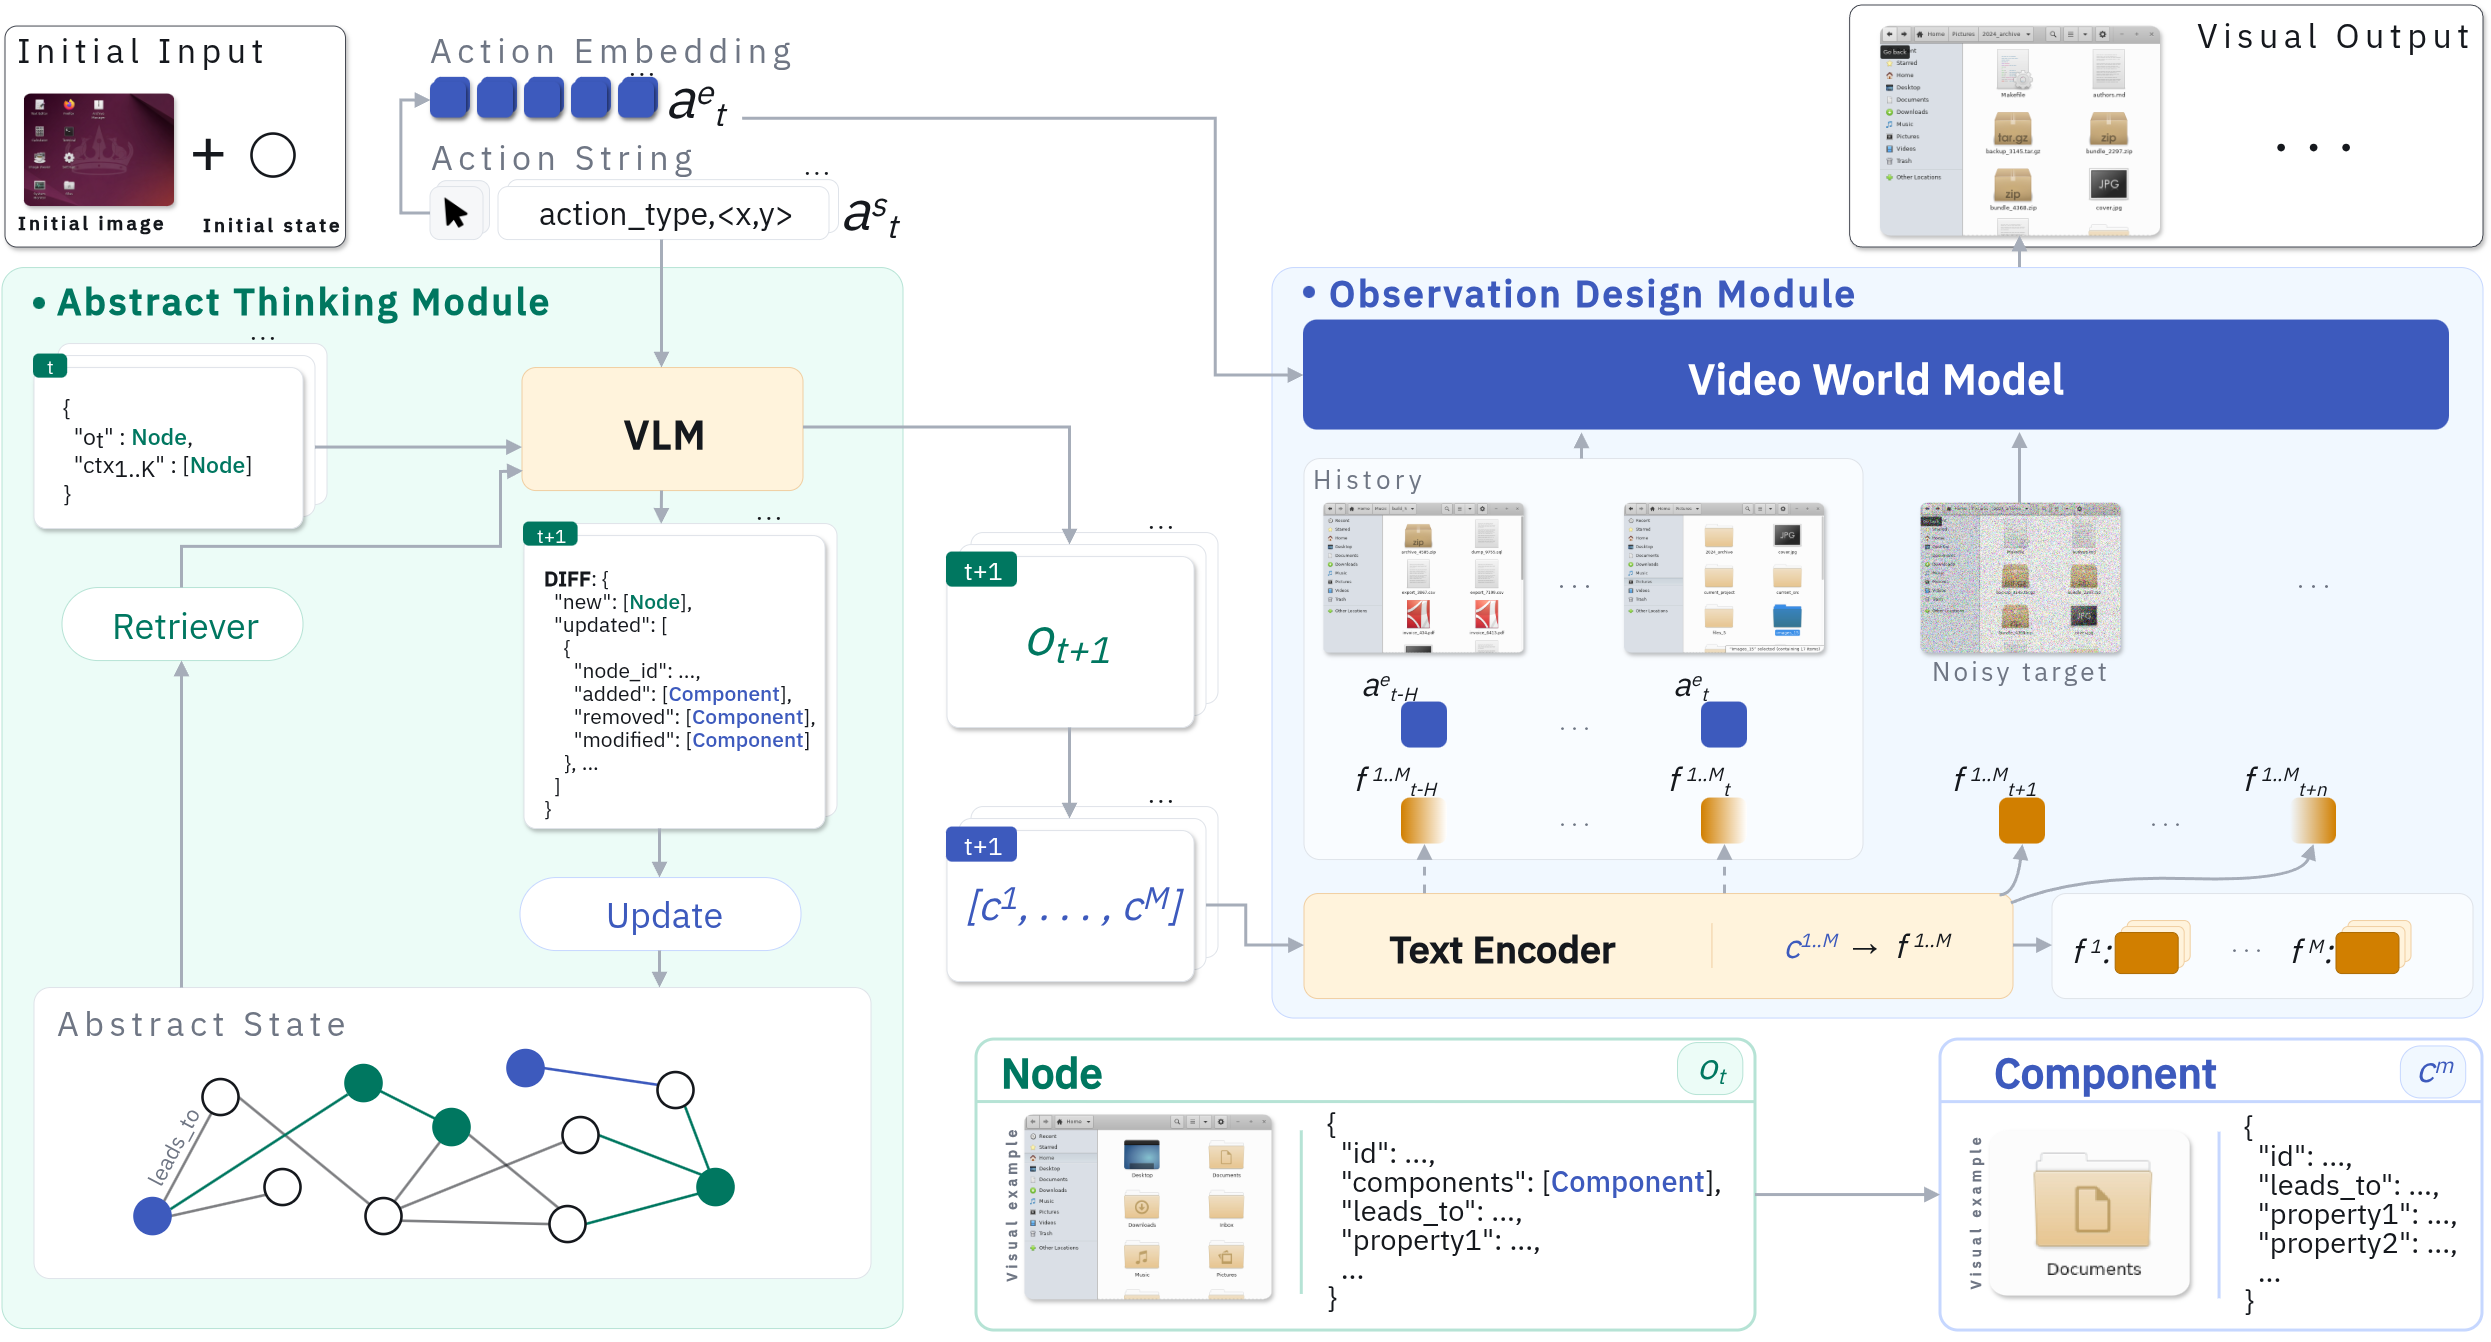
图2左侧状态M包含视图节点及元素。根据当前节点、动作坐标和组件边界解析目标,检索已见目的节点;经LoRA微调的Qwen3.5-0.8B接收序列化状态而非像素,预测新/相同/重访及节点差分Δ,随后更新M。
- 2
把每个元素独立编码给视觉生成器
每节点最多32个组件字符串,经冻结Qwen3文本编码器映射为1024维向量。图2右侧扩散模型每帧只对对应状态特征做交叉注意力,同时读取动作和历史帧;CF++版本从Wan2.1适配,推理两步去噪、缓存最多21帧。
- 3
先采集有意义的交互,再分阶段训练
通过GNOME Files可访问性树选择可交互元素,记录动作、画面和状态变化。1956条训练轨迹、586210个动作;先训练动作模型,冻结骨干预热新增条件层,再联合微调。损失提高文字与变化区域权重,避免固定界面背景掩盖错误。
- 4
按需更新抽象状态并允许人工编辑
门控读取生成上一帧时缓存的激活与下一动作,判断是否调用状态模型;无变化则沿用状态。修改图中名称、类型或隐藏内容可直接改变后续生成。门控漏判会保留过时状态,因此调用减少必须同时报告闭环误判。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据240条300动作测试中,StateCraft-CF++为28.78dB、SSIM0.95,CF++为18.49dB、0.78。首次访问提供文件名提示,基线按协议也获得提示或初始化帧;首次访问帧不计分。 长序列生成与首次访问条件 ↗
我的解读我的解读:这验证已给定内容的状态维护,不是模型凭空恢复未知真实文件系统。PSNR差也不能替代操作语义准确率。
来源证据184条匹配家族各测32至512动作间隔,目标内容保持不变;回访自一致性约0.9,另报真值重建0.92–0.94。编辑跟随81%,新增元素仅48%;未编辑控制区域PSNR由37.7降至23.88。 920条记忆轨迹与293个编辑片段 ↗
我的解读我的解读:自一致性不等于正确性,论文另给真值对照很关键;编辑也会污染无关区域。该回访测试不验证内容变更后的记忆更新。
来源证据闭环48轨迹9600决策省去40.8%调用,跳过纯度91.2%,有345次错误跳过;非99%离线纯度。3D测试两栋未见房屋120回合,照明AUC0.864对0.542,但状态由模拟器给定并提前8帧供条件,14真值潜帧后只生成7帧。 门控与3D概念验证的边界 ↗
我的解读我的解读:省调用不等于已证明端到端加速;3D只证明显式照明状态能控制渲染,不证明自主三维状态推理。
开放情况与使用许可
论文CC BY 4.0,项目页可访问;官方仓库master当前只有README,明确写Code coming soon,未见实现、数据或权重,不计作开源。
LICENSECC BY 4.0(论文与所引原图)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:把“世界状态如何变化”和“当前画面如何显示”分开,允许定位错误并编辑不可见内容,是可控生成界面的有用方向。
反方 · 哪些结论还不够
状态schema预定义,首次内容需提示;微调0.8B状态预测器在未见操作准确率由少样本1.00跌至0.00,存在明显泛化代价。
综合判断
适合结构明确的软件仿真与受控状态渲染研究,距离真实操作系统执行或开放环境自主建模仍有很大差距。
我会先做的验证
未执行的验证方案:在隐藏文件移动、删除与多窗口并发后重访,分别核对状态图真值、画面及门控漏判;去掉首次提示并加入全新操作,测累计错误和完整交互延迟。