StreamEval:把持续交互变成可核查的事件账本
视频系统能否在长会话中执行、保持、取消和恢复指令?
StreamEval 用300个带时间线的任务评估对话数字人、表演、世界生成和两类视频编辑,显式记录每次控制是否执行及状态是否保留。它揭示短片视觉质量与持续交互可靠性的差距;自动裁判校准、输入差异和论文与当前代码的协议变化都限制榜单横比。
图解主要方法
视频系统能否在长会话中执行、保持、取消和恢复指令?
- 1
第一步:按任务、时长和来源分层造案例
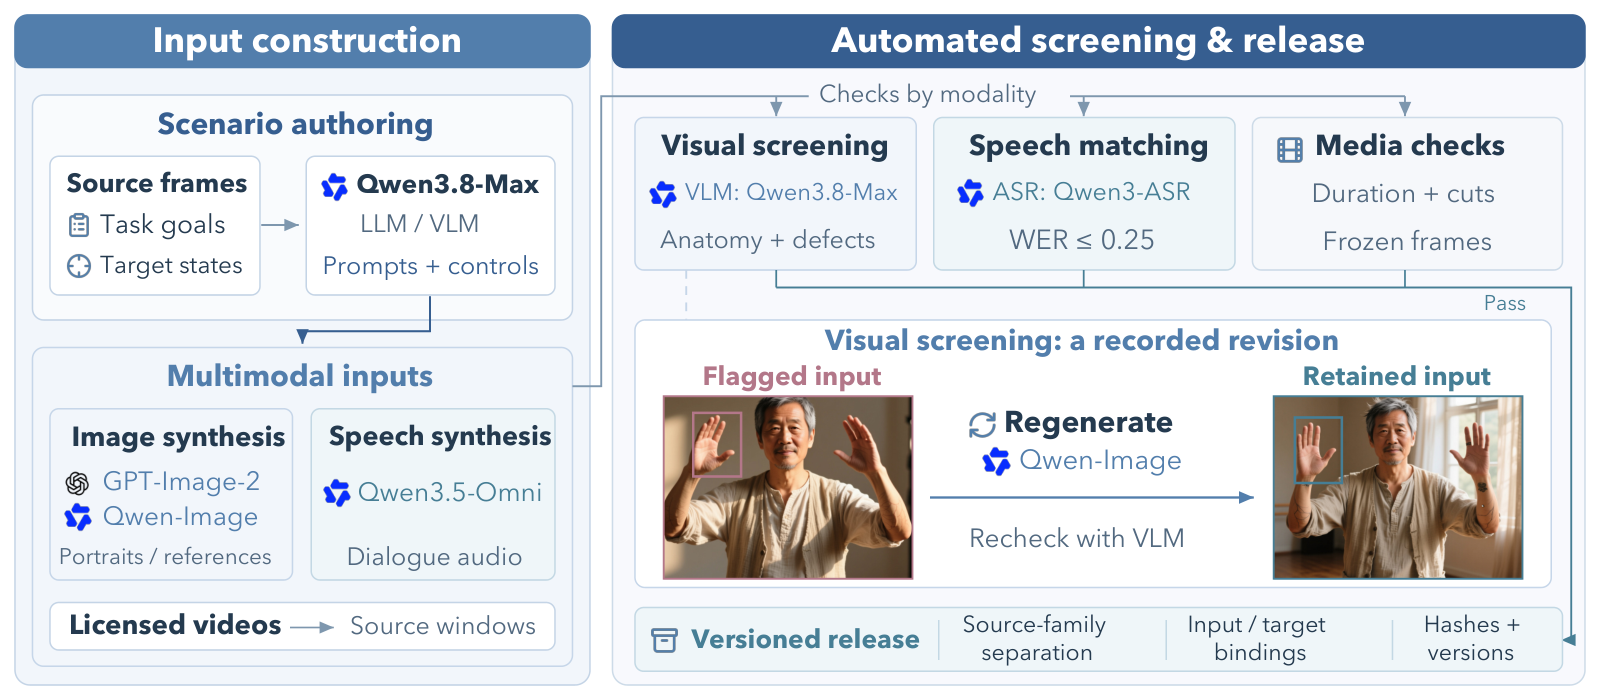
图2从任务目标、目标状态和控制事件出发,构造多模态输入,再做视觉、语音和媒体检查。五类任务各60例,15/30/60/120/300秒各12例;300例对应240个来源族与60个文本派生例,不能把所有样本看成完全独立的素材。
- 2
第二步:为交互维护状态和可观察证据
每条时间线规定何时建立、保持、取消、恢复属性,以及哪些内容不该变化。共1347个控制事件,带oracle目标供评测端使用;目标不是让生成模型提前读完整未来脚本,而是逐步接收输入后接受检查。这样能暴露恢复失败、状态遗忘和局部编辑污染。
- 3
第三步:将模型裁判变成结构化判断
自动视觉语言裁判输出结构化记录,再按规则汇总为Quality、Following、Continuity、Edit Success等指标。缺失输出按零分,未解决的裁判项保留不确定并在显示下界中计零。每例重复三次,按案例和时长组平权,避免五分钟样本天然压过短样本。
- 4
第四步:冻结版本后再谈排名
本文引用arXiv v1表格;当前仓库的evaluation_v2已写为适用指标等权均值,且图像条件世界生成加入Reference。论文v1还描述定制数字人额外加分等不同处理。因此不能将本文旧表数字直接混入当前协议重新排名;输入路线、模型版本和裁判配置都必须随结果保存。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据论文涉及37个独立模型、47种配置:15对话、7表演、17世界生成、5指令编辑、3参考编辑配置。 §2–3,覆盖与评估设置 ↗
我的解读不是37个模型都完成相同300题。固定头像与自定义头像、文本与图像条件,以及依赖共享语音栈的系统,输入条件并不等价。
来源证据世界生成中MemFlow Overall为33.36,Krea的Following为25.93;参考编辑最好的Edit Success也仅15。 v1世界生成与参考编辑表 ↗
我的解读视觉片段可生成不代表能持续按要求修改并保留状态。编辑表还有Overall≥5的展示筛选,读取表格时应说明筛选,不能把遗漏模型当不存在。
来源证据论文尚未提供充分独立人工成对判断验证;Quality和Stability存在定义重叠,音画检查采样间隔250/500毫秒而判定涉及±200毫秒。当前代码取消了论文所述额外加分式整体口径。 裁判与当前官方evaluation_v2说明 ↗
我的解读作者设定的裁判误差目标不等于已证明的独立准确率。较粗采样、复合指标与版本变化都要求保存原始证据和置信边界,排行榜不适合跨任务简单总排名。
开放情况与使用许可
2026-10-25核查官方仓库有benchmark、评估器与模型适配代码,Apache-2.0;Hugging Face数据仓库有实际素材文件,卡片标CC BY 4.0。来源视频仍需遵守逐项CC BY、CC BY-SA、CC0或公共领域说明;包装的模型也可能有非商业条款。论文v1与当前evaluation_v2有协议差异,未独立运行排行榜。
LICENSE论文及原图 CC BY 4.0;资源许可另见开放说明
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:把“修改成功”拆成目标、范围、时间和状态保留,比只打视频观感分更接近真实交互工具的验收需求,也便于定位世界模型长期漂移。
反方 · 哪些结论还不够
自动裁判并非地面真值,且系统输入能力与协议版本不完全一致;在没有人工一致性校验和匹配输入之前,分数差可能来自接口、裁判与计分规则。
综合判断
适合用作带审计轨迹的测试框架;先固定协议与输入组,再讨论同组系统差异,不把五类任务混成一个能力总榜。
我会先做的验证
未执行的验证方案:选择30例覆盖五种时长,由两位人工标注者独立判定所有控制事件,并与自动裁判逐项比较;固定evaluation_v2提交版本和相同输入路线,报告未解决率、假阳性/阴性、响应延迟及重试记录。