世界模型全文深读与原图讲解
SWIM:从行为记录学习世界模型该重视哪些状态
预测动作所需的状态变化,能否改善潜空间规划距离?
IN A NUTSHELL
SWIM 不直接增加推理模块,而先用离线轨迹学习状态维度权重,再让图像latent距离对齐加权状态距离。它针对均匀状态监督重复计算冗余坐标的问题,结果是稳定但较小的默认配置规划增益。
01
图解主要方法
预测动作所需的状态变化,能否改善潜空间规划距离?
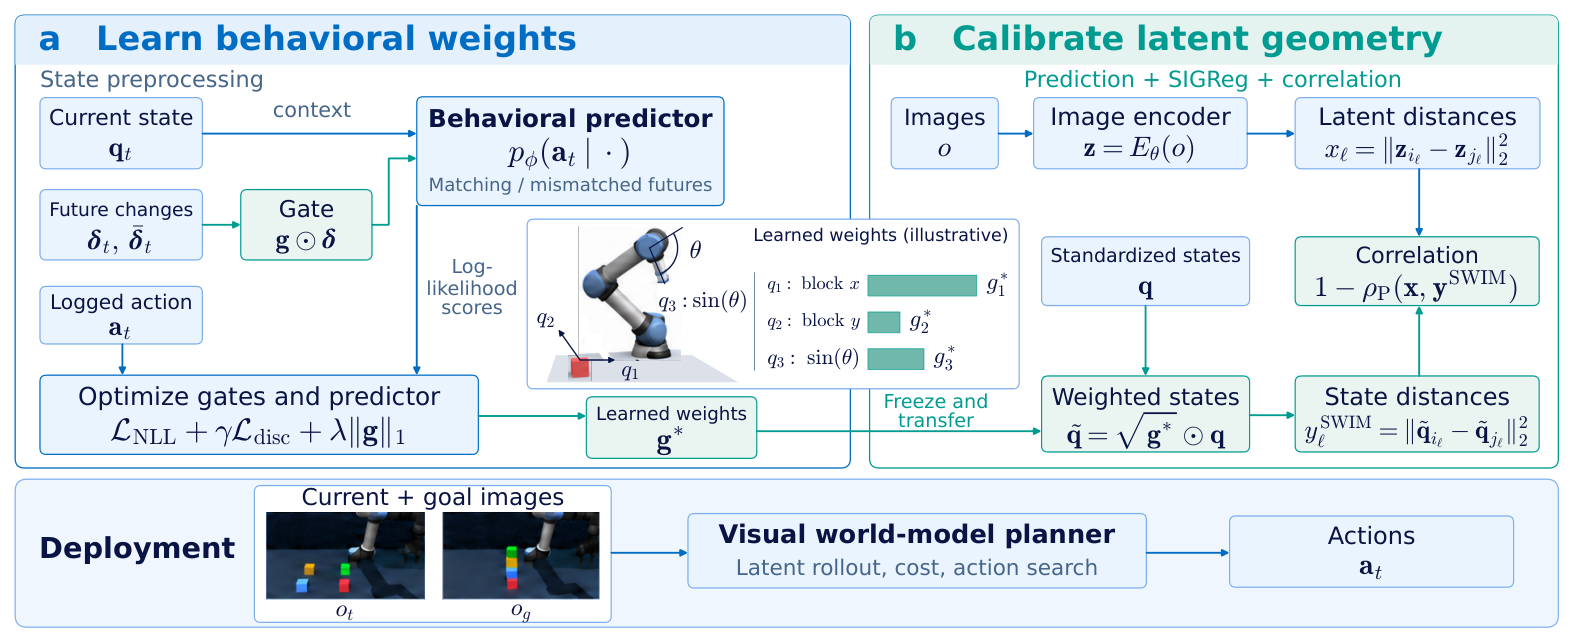
图1 · 行为门控与潜空间校准查看大图 ↗
波士顿大学、Unity Technologies,arXiv:2610.36662v1。引用方法讲解所需原图;原始插图以 PNG 格式呈现,图中内容未改动。 · 原始来源与图注 ↗ · 作者版权;arXiv非独占托管许可- 1
从未来变化反推已记录动作
图1左侧以当前状态和加权未来位移预测动作chunk。当前状态不加门,位移由共享sigmoid门加权;高斯负对数似然与匹配/错配判别项共同防止预测器完全忽略位移。
- 2
冻结权重后校准距离
用平方根门权重缩放已标准化的状态,得到加权平方距离,与相同帧对的图像latent距离作Pearson相关损失。不能再逐坐标标准化,否则门权重会被抵消;门的绝对尺度本身也不可识别。
- 3
部署仍然仅用图像规划
保留LeWM预测与SIGReg防塌缩损失,训练后丢弃逆动力学预测器与模拟状态。CEM/iCEM在latent里搜索动作,不增加在线状态读取;行为相关权重并不是任务因果权重。
02
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
03
开放情况与使用许可
预印本公开;未核实到本文独立代码、权重发布。LeWM或SCALE上游可用不代表SWIM实现已开放。
LICENSE作者版权;arXiv非独占托管许可
04
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
固定SCALE-All其他训练设置只改变监督距离,较清楚地定位了状态加权的作用。
反方 · 哪些结论还不够
状态特征仍需事先提供,行为覆盖决定权重;判别负例未确认不可达。损失消融单种子且成功率接近,不能据此断言每个损失都必要。
综合判断
可作为有模拟状态训练数据时的轻量改进;实际收益需按默认配置和训练种子衡量。
我会先做的验证
未执行的验证方案:在保持图像、轨迹和规划预算相同的条件下添加相互相关或任务关键但低动作相关的变量,测权重与成功率变化,并在新目标分布复测。