T2-z:只调一个小潜变量,让世界模型适应新物理
用一两条观测轨迹校准环境,再预测不同候选动作的结果。
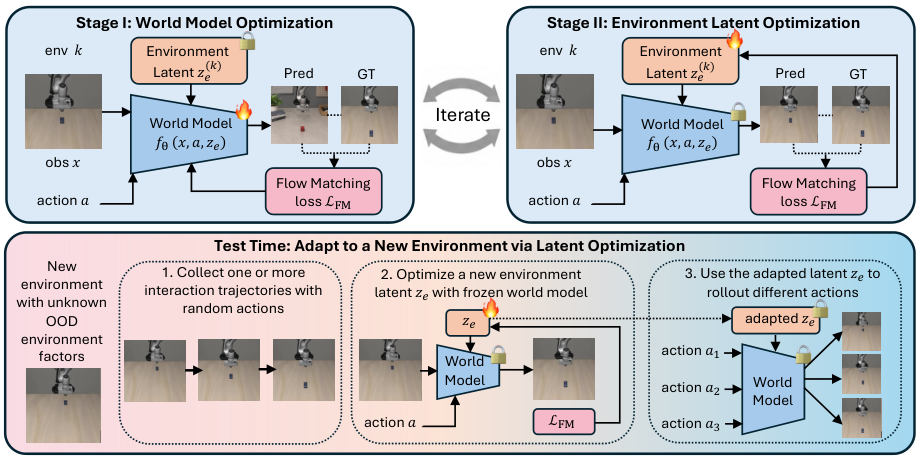
世界模型进入新环境时,摩擦、重力和物体属性可能不同。T2-z 将这些变化压进32维环境潜变量,测试时固定大模型、只用少量支持轨迹优化这个向量,再在独立查询动作上预测。价值在于便宜的环境校准,而非从零识别完整物理定律。
图解主要方法
用一两条观测轨迹校准环境,再预测不同候选动作的结果。
- 1
图3:把环境条件接到视频模型
以 Wan2.2-TI2V-5B 初始化 BWM,输入一张 RGB 与14维动作,冻结 VAE、关闭文本条件。32维环境向量经两层 MLP 映射到模型维度,作为 token 并通过自适应归一化注入,与按4步分组的动作共同调制预测。
- 2
训练时交替优化模型与环境向量
先300步模型热启动,再交替200步潜变量更新与200步模型更新,学习率分别0.03和1e-5。每个训练环境有独立潜变量并限制在[0,1],不需要摩擦或质量标签,但仍需要知道轨迹属于哪个环境。
- 3
测试时只用支持轨迹校准
新环境使用一或两条支持轨迹进行40步向量优化,学习率按3、1.5、0.5、0.15各10步递减;查询轨迹完全分离,不能用待预测结果调参。冻结模型使更新便宜,但支持动作必须激发出足以区分物理差异的信息。
- 4
用预测结果选候选动作
在相同观测与动作集合下比较预测,执行选出的动作。实验候选集合保证至少一个成功动作,所以测的是候选选择能力,不是任意环境中从零搜索出可行计划;潜空间结构可视化也不是物理参数可辨识性的证明。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据7项仿真平均误差12.8575降到4.7971,但该平均混合像素、百分比点与角度;4项真实任务平均像素误差19.30到10.85,任务宏平均成功率26.47%到70.80%。 仿真与真实任务表 ↗
我的解读不能把仿真总均值叫像素误差;真实宏平均也不是把所有试验合并后的成功比例,各任务图像裁剪和试验数量需保留。
来源证据质量摩擦任务成功率35%到69.7%;重力任务 T2-z 误差7.34,DINO方案5.93更低。SoftPull 的 LPIPS 为0.0758,高于基础模型0.07207和 TTT0.06439。 不是所有指标都更好 ↗
我的解读候选动作选择、位置误差和视觉相似度不是同一目标,不能用总体进步掩盖单项退化。
来源证据单张 H200 上40步适应加5个查询、每次25步去噪共18.09秒,LoRA32.73秒、TTT37.57秒;不含加载、数据准备和写盘。摩擦实验32维优于8/16/64/128维,直接3072维 token 不稳定。 运行时与潜维度消融 ↗
我的解读支持较小更新空间降低代价,但不是端到端机器人实时周期,也不能推出32维普遍最优。
开放情况与使用许可
作者代码仓库含训练、推理及配置,根许可 Apache-2.0;官方 Hugging Face 数据集可访问且为训练数据,本次未确认数据独立许可或任务训练完成权重,不能把代码许可自动套到数据。
LICENSECC BY 4.0(论文及所引原图)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
支持集与查询集分离、冻结主模型和多类物理变化评测,让“少量轨迹适应”有具体可核查的边界;这适合新物体操作前的短时校准。
反方 · 哪些结论还不够
一两条轨迹可能无法区分质量、摩擦等因素;没有证明自动主动探索或潜变量对应真实物理量。真实任务规模小、候选集已保证可行,视觉指标亦有退化。
综合判断
是测试时环境校准的有希望方案,证据支持在受控候选动作下改善预测和选择,不支持开放世界通用规划或物理发现。
我会先做的验证
未执行的验证方案:在没有保证成功候选的动作集上评估,加入支持轨迹不充分和环境中途改变的情况;分别报告各任务原始单位、规划失败、校准总时延和主动探索成本。