TexF:把纹理放回三维表面,压缩可以绕开 UV 吗
同一表面纹理场,两种成本口径:传输码率与显存占用
TexF 把纹理存进由网格表面决定的稀疏体素,分别面向传输压缩和 GPU 按需解码。它减少 UV 切割造成的相关性损失,但并不免除几何、训练和渲染成本;近邻薄表面可能串色,进入现有资产工具时仍常需要烘焙回 UV。
图解主要方法
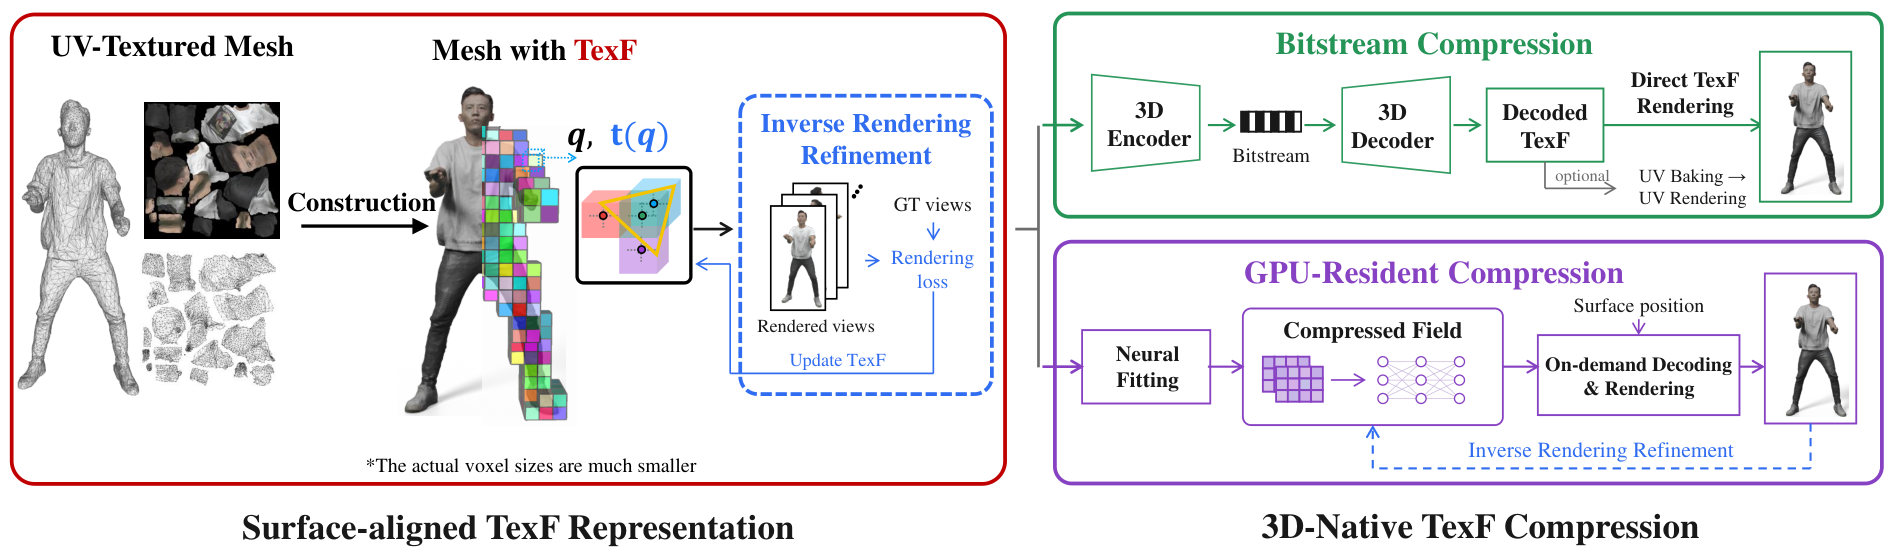
原图 3 左侧的表面场怎样构造,右侧两条压缩路线为何不能混算收益?
- 1
从已有带纹理网格构造表面稀疏场
在约 2K/4K 分辨率的规范网格中,只激活接近三角形表面的体素;通过三角形重心坐标从原 UV 纹理采样属性并汇聚。解码端可由相同网格确定体素坐标,因此不另传坐标;这依赖已有几何,不意味着几何码率消失。
- 2
在三维表面位置查询颜色
光栅化三角形得到像素的表面位置,再插值邻近八个有效角点并重归一化,必要时回退最近邻。颜色跨三维邻域连续,不受 UV 图集岛的切边直接影响;但距离很近的两层薄表面可能共享体素,出现另一种串色风险。
- 3
用图像空间逆渲染修正属性
保持几何和支撑不变,用多视图参考渲染的 L1 与 SSIM 优化属性。训练视图与测试正交视图分开,避免只拟合评价相机;目标是已有资产外观保真,不是从单张照片消除未知光照或生成新材质。
- 4
图 3 右上:压缩传输属性码流
使用 Unicorn 或 G-PCC/RAHT 等属性编解码器。比较中几何采用共同的无损设置并排除在报表之外,UV 对照计入 UV 映射成本;因此纹理码率节省不能照搬成完整网格资产包的节省百分比。
- 5
图 3 右下:压缩 GPU 常驻场
3DNTC 使用两级 INT4 哈希特征、位置编码与小型 FP16 MLP;先插值特征、再执行一次解码,避免每角点重复网络。每资产仍需拟合约十万步再做图像优化,按需解码也带来着色开销,不能把显存比当成网络传输比。
- 6
回到 PBR 与编辑管线
论文在两个 glTF 资产上示范金属度/粗糙度等通道,说明属性场可扩展,但不等于完整材质语义、滤波和重光照都获验证。原生 UV 编辑器需要重新烘焙;连续表示也不能自动保证 MIP、各向异性滤波、接缝或部件边界处理成熟。
实验与证据
以下为作者报告;已阅读 v1 全文及附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【40 资产】8 个 MPEG 人物、32 个 AOM 资产,2K–4K 纹理;相对原 UV+HEVC 的 PSNR BD-rate 为 −46.7%/−63.3%。 主码率实验 ↗
我的解读这是等质量纹理传输码率的平均变化,几何共同排除。不是每个资产都达到该幅度,也不是整个文件缩小同样比例。
来源证据【GPU 常驻比较】相对 UV+ASTC 的平均存储节省约 33.2%/31.0%。 GPU 存储结果 ↗
我的解读显存与码流使用不同表示和成本口径,不能将两个百分比相加。
来源证据【A6000,2048²】3DNTC 两组平均帧时约 10.8/23.1ms;NTC 8.9/21.3ms。 运行时间比较 ↗
我的解读场压缩更省不保证渲染更快;该卡没有相应 ASTC 硬件路径,论文未给 ASTC 对等实测帧时。
来源证据【离线代价】3DNTC 编码约 1006/1707 秒,NTC 约 34.4/36.3 秒;显式场的短时优化是另一个步骤。 效率与补充实验 ↗
我的解读不能用“显式场构建不到十秒”替代神经压缩总训练时间。
来源证据【兼容性】示范烘焙回 UV 约 1.6/19.8 秒,且有少量率失真损失;PBR 仅两个资产例子。 补充材料:UV 烘焙与 PBR ↗
我的解读具备接回现有工具的路径,但还需独立验证纹理层、法线、切线和跨部件边界。
开放情况与使用许可
已检查作者仓库树、README 与演示入口:目前为项目网页、展示资源和交互图像比较,README 明确代码将发布;尚非已公开纹理编解码实现。
LICENSE论文 arXiv 非独占分发;当前未确认正式软件许可证,不将展示仓库视为已开源实现。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
显式网格维持几何,纹理利用表面三维相关性,清楚地把几何表示与纹理传输/驻留分开,适合资产压缩研究。
反方 · 哪些结论还不够
近距离薄面、滤波成熟度和逐资产神经拟合成本是实际限制;PBR 样例不能替代大规模材质、去光照或重光照验证。
综合判断
是有价值的无 UV 纹理表示路线,当前更适合受控资产压缩评估;进入生产前应按实际渲染器和编辑链逐环节测量。
我会先做的验证
未执行的验证方案:选薄壳、折叠布料、多部件及多种 PBR 材质,在同网格和同相机下比较接缝、串色、远景滤波、随机访问帧时、总包大小与烘焙后误差,并完整记录每资产训练时间。