Thinker-WM:把视频、深度与机器人动作放进同一个生成模型
统一生成三种模态,是否能让世界预测和闭环控制共同受益?
Thinker-WM在Wan2.2 TI2V 5B基础上统一RGB、深度和动作的流匹配建模,通过不同条件组合兼容世界预测、动作推断和联合生成。其深度交互消融显示模拟控制收益,但广泛视频评测、有限闭环实验与真实机器人部署证据必须分别看待。
图解主要方法
统一生成三种模态,是否能让世界预测和闭环控制共同受益?
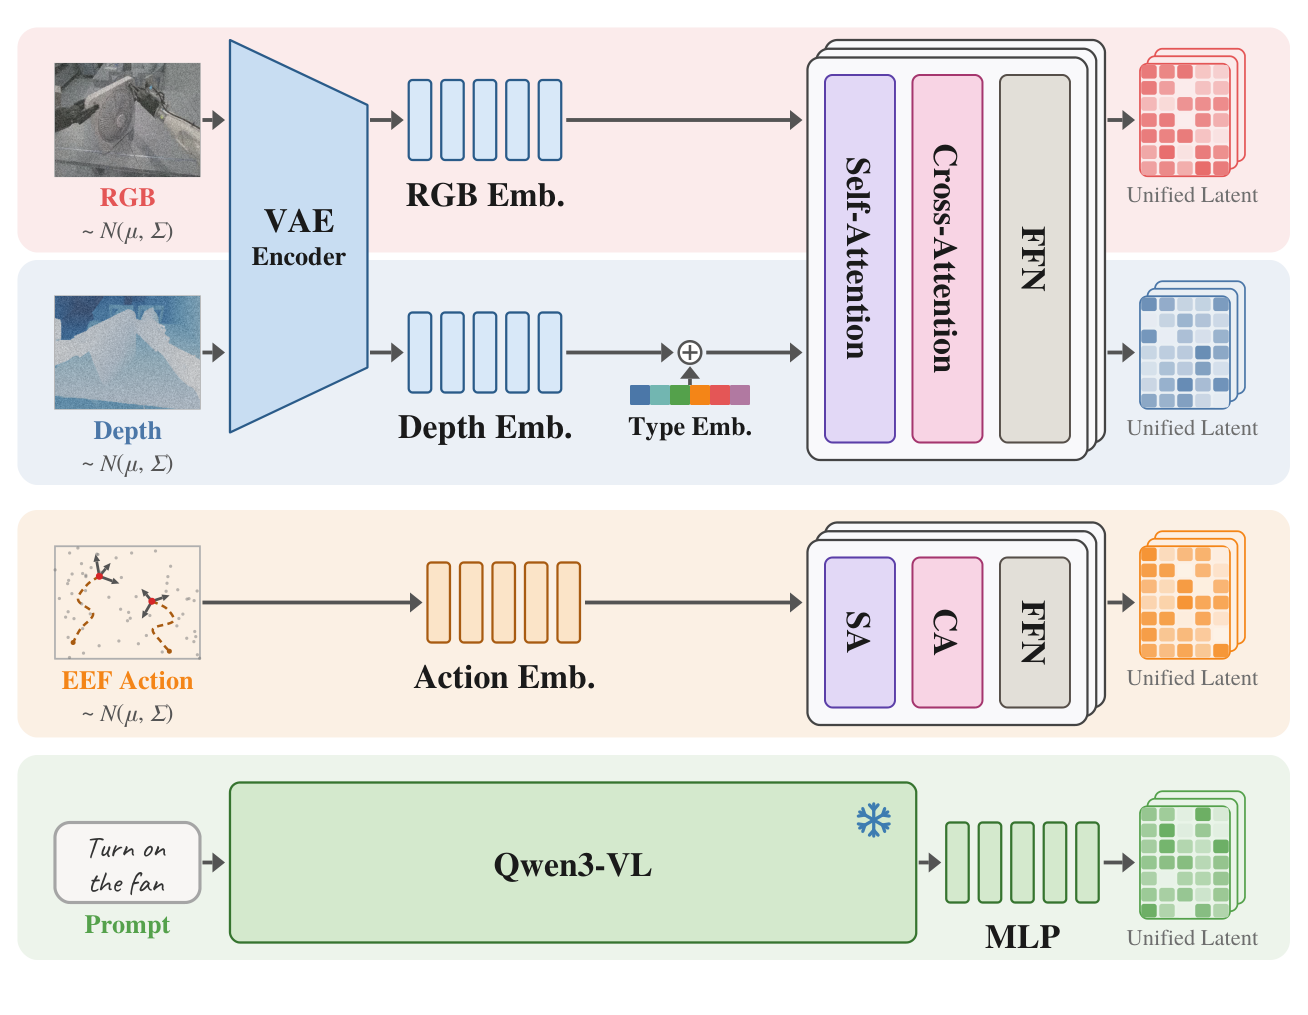
- 1
保留各模态编码,再进入共享Transformer
RGB和深度分别经VAE与嵌入进入共享UDT;48步动作块采用20维表示和有效维度掩码,并加入机器人身份token。冻结Qwen3-VL提供任务条件,不是第四种需要生成的模态。原图2(a)仅展示编码侧,不能将它当成整套训练流程。
- 2
在统一时间轴上混合条件与生成目标
49帧视频压成13个时间潜变量,视觉patch与动作以不同token数进入模型。动作位置相对初始末端位置、旋转相对初始姿态表示,缺失自由度不加噪。六种模式包括联合世界动作、世界模型、VLA、动作到视频、视频到动作和无条件生成;联合模式占一半,其他各占十分之一。
- 3
按深度可靠性逐步开放信息交换
单目或双目模型产生伪深度。预训练时深度流可读取RGB与动作,但不让不可靠深度反向污染它们;使用可靠目标机器人深度后才开放双向交互。深度经过对数编码,这不是全程对称的RGB-D融合。
- 4
用条件掩码和模态噪声级实现不同任务
已知条件模态置零流时间且不计算生成损失,缺失模态不进入图;生成模态执行流匹配。推理使用50步视觉采样、10步动作采样,视觉使用分类器自由引导。长视频展示以分段指令和历史条件续接,不等于自主长程规划。
实验与证据
已阅读论文全部正文、实验、讨论与贡献声明;该HTML版本未另列附录,核对实验条件与原图;未独立复现。
来源证据训练混合约2万小时自我中心视频、1万小时机器人数据、1000小时仿真和约4000小时深度。论文WorldOlympiad均值0.740;模型卡列0.739。WorldArena71.73使用去除三项运动指标后的12指标口径。 训练数据与多榜评测口径 ↗
我的解读含私有数据,不能视作完整可复现数据集;数值版本或舍入差异应保留,不能冒称当前实时榜首,也不能将12指标分数直接对比15指标榜单。
来源证据48段AgiBot序列中AbsRel为0.136、RMSE为0.179米。RoboTwin turn_switch在三个训练检查点、各20次测试上,RGB为60%、单向深度63.3%、双向深度75%。 深度重建与闭环消融 ↗
我的解读三个检查点不是三个独立训练种子;这个单任务消融支持双向深度可能有用,但不能外推为广泛实机控制提升。论文明确将实机闭环评估留作后续工作。
来源证据EWMBench使用21段、7任务,每个提示生成3个候选并按Hausdorff距离挑选;论文报告4.66。WorldArena图像质量37.26低于Wan的67.36,指令指标78.86低于UNIS的93.86。 世界视频指标的边界 ↗
我的解读候选择优和视频帧率转换都是实验条件;总体分数不能掩盖特定指标退化。展示可控视频与执行机器人任务是两种不同证据。
来源证据冻结特征探针使用96个保留窗口,教师轨迹逐窗口与真值Sim3对齐,并筛选高质量样本;论文报告末端误差0.041米。115.2秒视频由12个片段串接,各片段提供指令。 运动探针与长序列展示 ↗
我的解读对齐和筛选降低了问题难度;可解码运动信息不证明模型因果理解动作。长视频主要为定性展示,尚缺累计漂移、任务成功率与失败恢复统计。
开放情况与使用许可
官方仓库提供推理实现,Hugging Face仓库存在checkpoint/pytorch_model_0.bin与VAE等实际权重文件,未设访问门槛。代码和模型采用CC BY-NC-SA 4.0,包含非商用及相同方式共享限制;不应描述为无限制商用开源。训练数据与完整训练复现范围另行区分。
LICENSECC BY-NC-SA 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
统一模态目标与逐步开放深度信息流的设计可解释,单任务消融明确比较RGB、单向与双向深度,提供了比展示视频更具体的证据。
反方 · 哪些结论还不够
大规模私有数据、候选择优、指标口径调整及单任务闭环消融限制外推。运动探针依赖教师对齐与筛选,真实机器人长期运行和安全恢复尚未充分验证。
综合判断
可作为统一世界动作模型的研究起点,已有推理代码与权重可检查,但当前证据不足以认定它已解决通用实机闭环控制或长程自主规划。
我会先做的验证
未执行的验证方案:固定训练数据和预算,以独立随机种子重复深度消融;关闭候选择优报告全部样本,统一12项与15项指标;在实机测不同相机、深度缺失、接触失败与连续多任务恢复,并报告成功率区间及延迟。