UniPart:用一句话定位三维资产的功能部件
回顾补收:数据引擎、逐层文本注入与点云蒙版
UniPart 用大规模文本—部件数据训练点云 Transformer,让自然语言短语直接选择已有几何中的部件。它属于三维资产理解和编辑入口,输出点云蒙版,不能直接生成完整网格或 PBR 材质;本条只计入 3D 领域。
图解主要方法
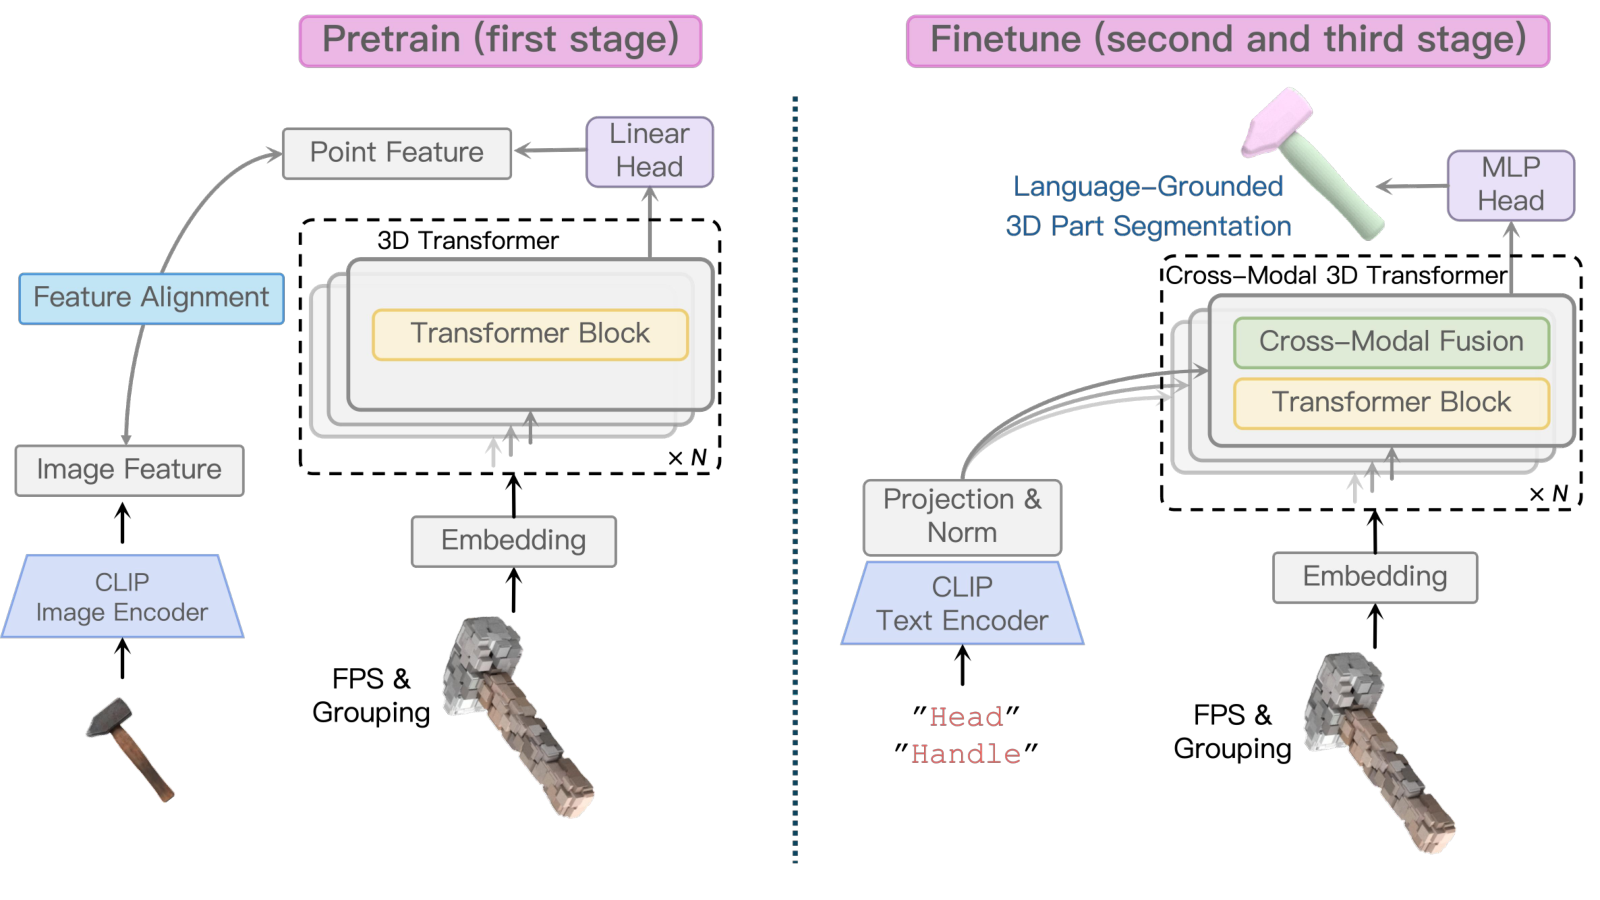
图 3 怎样将图像语义预训练迁移到文本指定的部件蒙版?
- 1
用多视图构建语言—部件监督
从清洗后的 160K+ Objaverse 资产渲染视图,用 SAM 区域和编号提示让视觉语言模型将区域合并到部件名称,再按相机与深度回投三维,形成约 8M 文本—部件对。跨视图同名合并减少碎片,但教师误判仍可进入标签。
- 2
先对齐点特征与图像特征
对单视图点云,以已知投影对应将点特征对齐冻结 CLIP 图像块特征,学习语义初始化;之后在大规模自动数据与人工修正子集上分两阶段训练二元分割。LangPart-4K 分为 3K 训练与 1K 评估。
- 3
每一层都加入文本条件
最远点采样与近邻组形成 PointNet 局部 token,冻结 CLIP 文本嵌入投影后在每层加到点 token。Transformer 汇聚几何与语义,再上采样为每点二元预测;短部件词在此设置中不需要复杂交叉注意力。
- 4
把蒙版交给后续资产或抓取工具
推理直接读取点云与文字,不需要为每次查询重新渲染多视图;部分点云与完整几何分别训练模型。输出仅标记观测点,没有补全背面、建立拓扑、UV 展开或材质分层;后续资产操作和机器人抓取仍靠独立模块。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【Objaverse-General,短部件查询】已见类别 mIoU 49.27、未见 45.23,FIND3D 为 34.10、27.41。 表 2 ↗
我的解读我的解读:零样本指对测试类别/基准的迁移,不是模型没有接受部件监督;资产 ID 去重也不能自动排除近重复几何。
来源证据【相同监督对照】FIND3D/原数据 30.75,UniPart/原数据 35.27;FIND3D/新数据 38.42,UniPart/新数据 47.25。 表 6 ↗
我的解读我的解读:数据和架构都有贡献;35.27−30.75 是 4.52 个百分点,不应将论文的相对 14.69% 写成百分点。
来源证据【LangPart-1K】单视图预训练版本短查询 33.56,完整点云模型 27.17;无预训练分别 26.34、23.39。 表 4、7 ↗
我的解读我的解读:两套模型与输入协议不同,完整几何并不在这张表上自动得分更高,不能混成同模型消融。
来源证据【真机展示】20 个真实对象,报告人工观察分割准确率 90.5%、目标部件抓取 85.0%。 机器人实验 ↗
我的解读我的解读:论文未充分交代逐物体试验次数和分母,且使用 GraspNet/DexGraspNet;不能把该数字当独立分割模块的一般闭环成功率。
开放情况与使用许可
已打开作者项目页和完整论文;页面未提供可核实的本研究代码、模型或数据下载。正文对过滤提示、资产 ID、划分和中间标注使用将来发布措辞,因此暂不标为数据或实现开放。
LICENSE代码、模型和数据许可待确认;Objaverse 资产仍各自授权。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
大规模数据与架构做交叉对照,能区分性能提升是否只是更多监督;语言部件选择也可作为资产编辑接口。
反方 · 哪些结论还不够
自动标注噪声、基准表格排版异常及机器人统计细节不足限制证据;没有网格补全或材质生成能力。
综合判断
适合作为三维资产的语义选择层,后续须与网格边界、部件封口和材质编辑联动测试。
我会先做的验证
未执行的验证方案:在未见扫描资产上使用同义词、歧义词和部分遮挡查询,测点云 IoU 与映射到网格后的边界误差;再验证选区编辑是否破坏 UV、接缝及相邻部件材质。