Unitas:用统一三维点轨迹连接动作和场景变化
1.7B世界动作模型;公制坐标减少视角歧义,直接控制却无需预测未来场景
Unitas让图像特征、机器人或人手的点轨迹、环境点的位移在每个预测窗口内共享公制坐标。它把不同帧率的一整条点轨迹压为一个token,用几何动力学专家学习动作流和场景流,并由另一个动作专家输出可执行命令。仿真显示较好的视角鲁棒性和场景位移预测,但纯策略推理跳过两种未来点流;优势主要说明几何监督有用,不能等同于每次控制都在做三维规划。
图解主要方法
以共享公制点轨迹学习动作和后果,能否兼顾直接控制效率与可量化的世界预测?
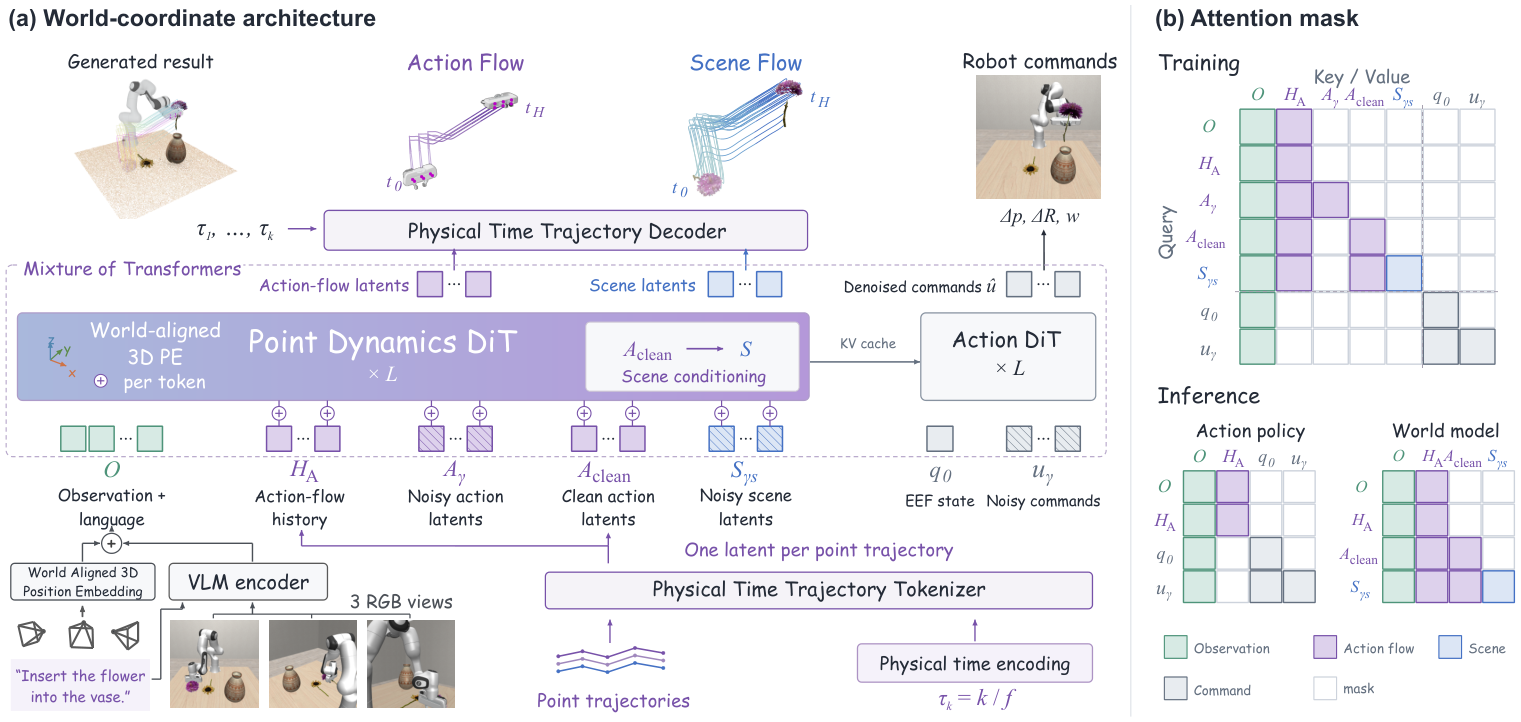
- 1
先统一每个窗口的公制空间
机器人数据用基座/共享躯干坐标,人手视频用窗口起始相机坐标并保持固定;RGB-D反投影后加Fourier三维位置编码。没有深度时在标定射线上0.1–2米的64个候选深度上学习特征权重,训练以可靠深度特征监督,不能理解成无需标定的空间恢复。
- 2
将形态不同的运动转为有身份的点轨迹
每机械夹爪采20个URDF点,用运动学跟踪;每人手用21个MANO关键点。非机器人场景点单独采样,仿真提供有效对应。点的当前位置作空间锚,未来输出为相对锚的位移。
- 3
用秒而非帧编号压缩轨迹
共享3秒时间尺度,256维MLP/FiLM编码整条轨迹为一个token,历史用负时间;先用重建训练再冻结,按训练统计标准化。空间锚与位移latent分离,查询点重排时输出相应重排。
- 4
用掩码分开动作、命令和条件场景预测
Florence-2视觉语言骨干加28层点动力学/动作专家。动作流与命令可并行采样,场景流训练条件为干净示范动作流;命令不读未来动作或场景流,纯策略能全部跳过。三种流匹配损失各权重1,位置蒸馏0.1,缺失标注掩码。
- 5
按用途选择推理模式
纯策略仅10步Euler生成命令;世界模型由外部或生成的动作流条件预测环境点轨迹,缓存条件KV。输出点颜色保留初始RGB,未知表面不合成,不能误称完整动态三维重建。
实验与证据
全文及附录A–G已读,图2架构与注意力掩码已视觉核对;检查官方项目页、GitHub目录、README及许可接口;未复现。
来源证据九种数据源预训练200k步,全局batch1,024,64张64GiB BW1000_H DCU;专家学习率10⁻⁴、VLM10⁻⁵。 附录A.1–A.3 ↗
我的解读无混合预训练版本仍初始化Florence-2,不是从零;混合数据含目标仿真训练来源,结果是后续微调而非目标任务零样本。
来源证据LIBERO99.8%、LIBERO-Plus89.1%;RoboTwin Clean92.94%、Randomized93.04%,50任务每条件每任务100次。 表1、10、12 ↗
我的解读平均领先不表示逐任务领先,Clean对LingBot-VA92.93%仅0.01点;LIBERO-Plus无另行适配,但需区分试验随机性和训练seed。
来源证据VLABench平均SR56.2%、PS67.6%、IS69.3%;跨类别SR28.9%低于π0.5的38.2%。 附录D表11 ↗
我的解读不能把平均成功率领先写成所有泛化轨道或所有指标最好。预训练使自身IS从71.2降到69.3。
来源证据真机整理书18/20、装球并拉链16/20,平均85%;π0.5为15/20及11/20。 4.3表2 ↗
我的解读样本小且未报多seed,标题/引言65%与表2不一致,使用可核对计数而不自行合并版本。
来源证据移除动作流监督78.89%、移除历史75.92%、三项全去67.58%;参考85.74%,加场景监督86.47%。 4.4表3 ↗
我的解读这是无混合预训练消融;场景预测额外提升仅0.73点,不能把整体18.89点都归未来场景建模。
来源证据无深度路由84.43%,同checkpoint真实深度84.68%;共10,030次、100k步训练且无场景监督。 附录B表9 ↗
我的解读深度可省只对策略输入且保持标定/状态,不能外推场景查询无需几何;与最终89.1不是同一设定。
来源证据世界预测550片段、50任务各1Clean+10Randomized;20未来帧只评分第4/8/12/16/20帧,运动阈值真值位移>1厘米。 附录F.1 ↗
我的解读每任务—条件等权,非550片段直接等权;只用首帧深度校准视频,不用未来真值,但视频转三维管线仍引入额外误差。
来源证据Unitas移动ADE/FDE0.427/0.825厘米、静态ADE0.043,Acc(1厘米阈值)92.31%;PointWorld0.656/1.050/0.084/88.22%。 表4 ↗
我的解读49%降低对应静态漂移,而移动ADE/FDE约35%/21%,不能写全部位移误差都降低49%。
来源证据闭环三任务六设置各10次:移动ADE1.211厘米、Acc(1厘米阈值)64.26%;全部结果保留失败episode。 附录F.2表13 ↗
我的解读各方法走自己的轨迹、保留不同预测时长,Fast-WAM改为执行完整32步;一致性是间接证据而非同分布因果对照。
来源证据5090D纯动作55.77ms/chunk,动作+流122.51ms,两种流1,024点305.49ms、3,000点561.60ms。 附录A.4表8 ↗
我的解读2.20倍是同模型去掉动作流,2.81倍是对Fast-WAM无视频;不代表含感知通信的真实控制频率。
来源证据tokenizer每来源600保留窗口,人手ADE4.68mm/FDE8.18mm;附录G展示19个仿真训练片段。 附录A.2、G ↗
我的解读重建误差不是未来预测误差;训练片段展示不抵保留集量化,DROID/RH20T无真实场景轨迹对照不能据图证明零样本精度。
开放情况与使用许可
论文摘要称代码可用,但当前DexForce/UNITAS根目录只有.gitignore、README和assets;README的推理代码、检查点、训练评估说明均未勾选,尚不能确认实现开源。官方项目页有交互展示,检查点Coming soon。
LICENSE论文与图2为CC BY 4.0;检查GitHub许可接口返回404且未见LICENSE,不能把论文许可延伸为软件或权重许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
LIBERO-Plus无混合预训练消融:移除视觉3D位置编码,85.74%降至81.35%,相机扰动79.11%降至66.73%。
550个仿真测试片段在匹配起始点与动作条件下,移动点ADE0.427厘米,优于PointWorld的0.656厘米;支持此基准的几何预测优势。
反方 · 哪些结论还不够
动作流与实际命令是分开生成,场景条件用的是动作流,不是从真实命令反算;闭环一致性虽有改善,仍非结构保证。
视频方法还承担深度估计和三维跟踪误差,且闭环各走自身轨迹与不同时间窗,不能全归因于动力学更准确。
真机仅两个任务各20次;引言Pack the Ball写65%,正文表2为16/20=80%,本文以具体计数为准并披露矛盾。
综合判断
公制空间监督和物理时间压缩是有价值的接口设计,仿真结果较强;可复现性、真实世界预测精度和更长时物理一致性还需开放实现及独立检验。
我会先做的验证
建议实验(尚未执行):固定数据预算与相机标定误差,比较3D位置编码、动作流、场景流贡献;把预测命令经运动学转为场景条件,与独立动作流对照,再以真实多视角轨迹真值测长时接触、遮挡和形变。