Velox:按三维重叠挑选历史注意力
长视频世界模型能否保留全部历史,却只读取当前视角需要的部分?
Velox 在 LingBot-Fast-Cam 上增加免训练的几何辅助稀疏注意力:保留历史 KV,利用流式三维估计选择相关块,再由模型自身的重要性补足几何盲区。它降低长上下文的去噪开销,但不解决历史缓存持续增长。
图解主要方法
长视频世界模型能否保留全部历史,却只读取当前视角需要的部分?
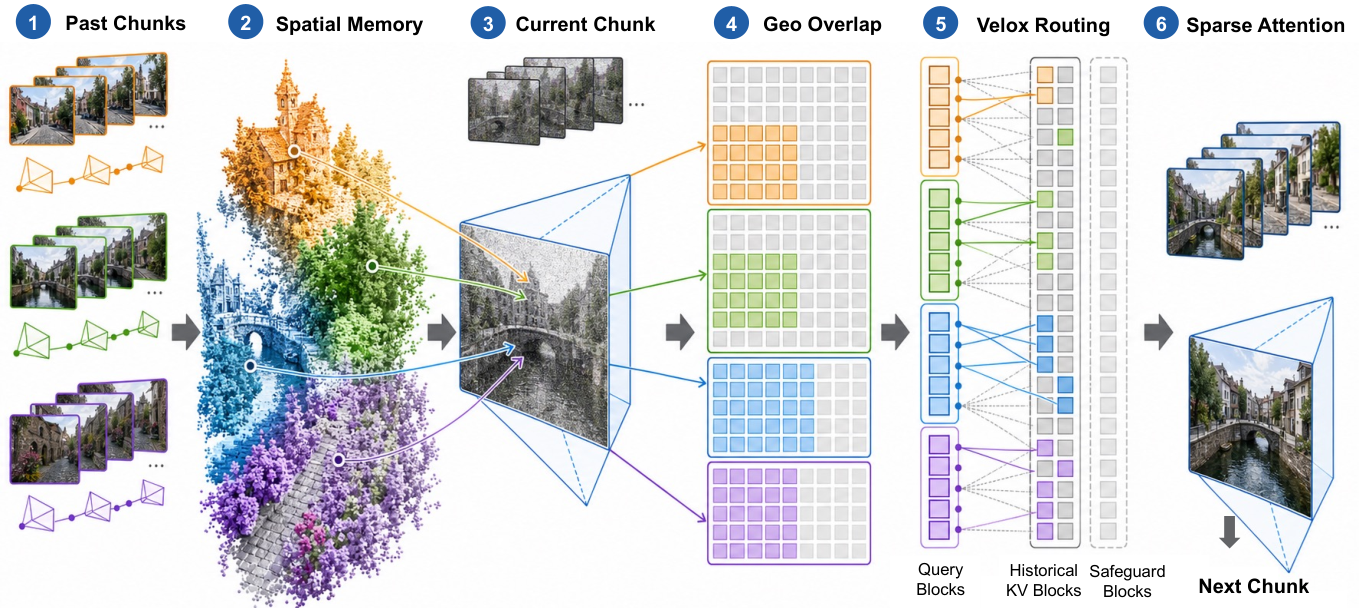
- 1
1 · 把图像块变成空间范围
图2从历史视频块开始。LingBot-map 提供流式几何,ViPE 相机通过旋转、平移和尺度对齐到共享坐标。每个128-token块用深度10%–90%分位范围形成视锥片段;跨帧块可拆成多个片段。近期可用观测优先,剔除最低20%置信度,避免把每个像素都当成精确三维点。
- 2
2 · 用几何增强模型重要性
对当前块与历史块估计包围体重叠。几何覆盖达到0.9时才采用相应路由,重叠将每层池化QK重要性作乘性增强,最多约3倍;可靠区域预算80块,欠覆盖区域退回累计重要性策略,上限150。前一视频块在预算内,邻接与参考保护块可在预算外,因此80不是最终严格块数。
- 3
3 · 真正执行块稀疏注意力
Gilbert排列及对齐使局部图像更容易落入连续块,Triton内核只执行被选择的块,不是先计算全注意力再遮罩。几何与VAE在同一H200异步工作,采用两块延迟。它缓存历史而不驱逐KV,池化重要性计算也仍随历史增长。
- 4
4 · 分清计时边界
论文将注意力调用、去噪关键路径与几何异步处理分开;预热不计入计时,尾部可跳过无后续用途的几何工作。报告的加速不能直接替换为用户从输入到最终视频的总等待时间。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据48块时注意力34.2→7.8ms,约4.36倍;去噪7.19→2.96秒,约2.43倍,同一H200。 长上下文效率实验 ↗
我的解读支持在长历史下减少主要计算;不是恒定显存或全流程4.36倍。
来源证据API-free分数dense为73.66、Velox为73.51,模型重要性稀疏方案73.11;部分指标下降,如透视81.7→77.0、主体87.2→86.4。 WBench,158段导航序列 ↗
我的解读应按73.66与73.51的轻微损失评价速度质量权衡;几何路由不是所有质量维度都更好。
来源证据两条校准轨迹上,几何增强使召回0.602→0.852,约9%选择改变;部分公开榜单与本文使用不同VLM评审。 路由消融与比较口径 ↗
我的解读局部注意力召回解释机制,样本较小;不同评审分数不能作为严格排名。
开放情况与使用许可
论文采用CC BY 4.0;本次全文未给出Velox官方实现仓库,链接的Block-Sparse-Attention是依赖,不能代替本方法代码开放证明。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
这项工作把历史记忆的读取问题落到三维可见性上;已有相机和几何模块的交互视频系统可借鉴其保守回退机制。
反方 · 哪些结论还不够
动态物体、细结构、遮挡解除以及两块滞后的深度会影响路由。完整KV仍增长,几何误差与块预算之外的保护块使实际资源需求不能只看预算数字。未验证物理动力学或闭环规划。
综合判断
值得作为长上下文推理加速方案继续验证;现有证据支持速度与质量的折中,不支持无限长世界记忆已解决。
我会先做的验证
未执行的验证方案:在相同模型、固定随机种子与相机轨迹上比较dense、模型重要性、几何路由及随机/最近历史;报告首帧到末帧总耗时、峰值显存、回访一致性与动态遮挡失败率,并把历史扩到48块之外。