视频扩散数字人:分开控制表情与视角
视频看起来像三维,不代表已经得到可编辑头像资产
研究借助视频扩散模型进行单图数字人驱动,分离表情与相机并提升新视角一致性。它与三维资产流程的关系是生成多视角外观与运动参考;输出主要仍是视频,没有直接交付带 UV、独立材质或可重光照的三维头像。
图解主要方法
视频看起来像三维,不代表已经得到可编辑头像资产
- 1
先拆开驱动信号中的相机混入
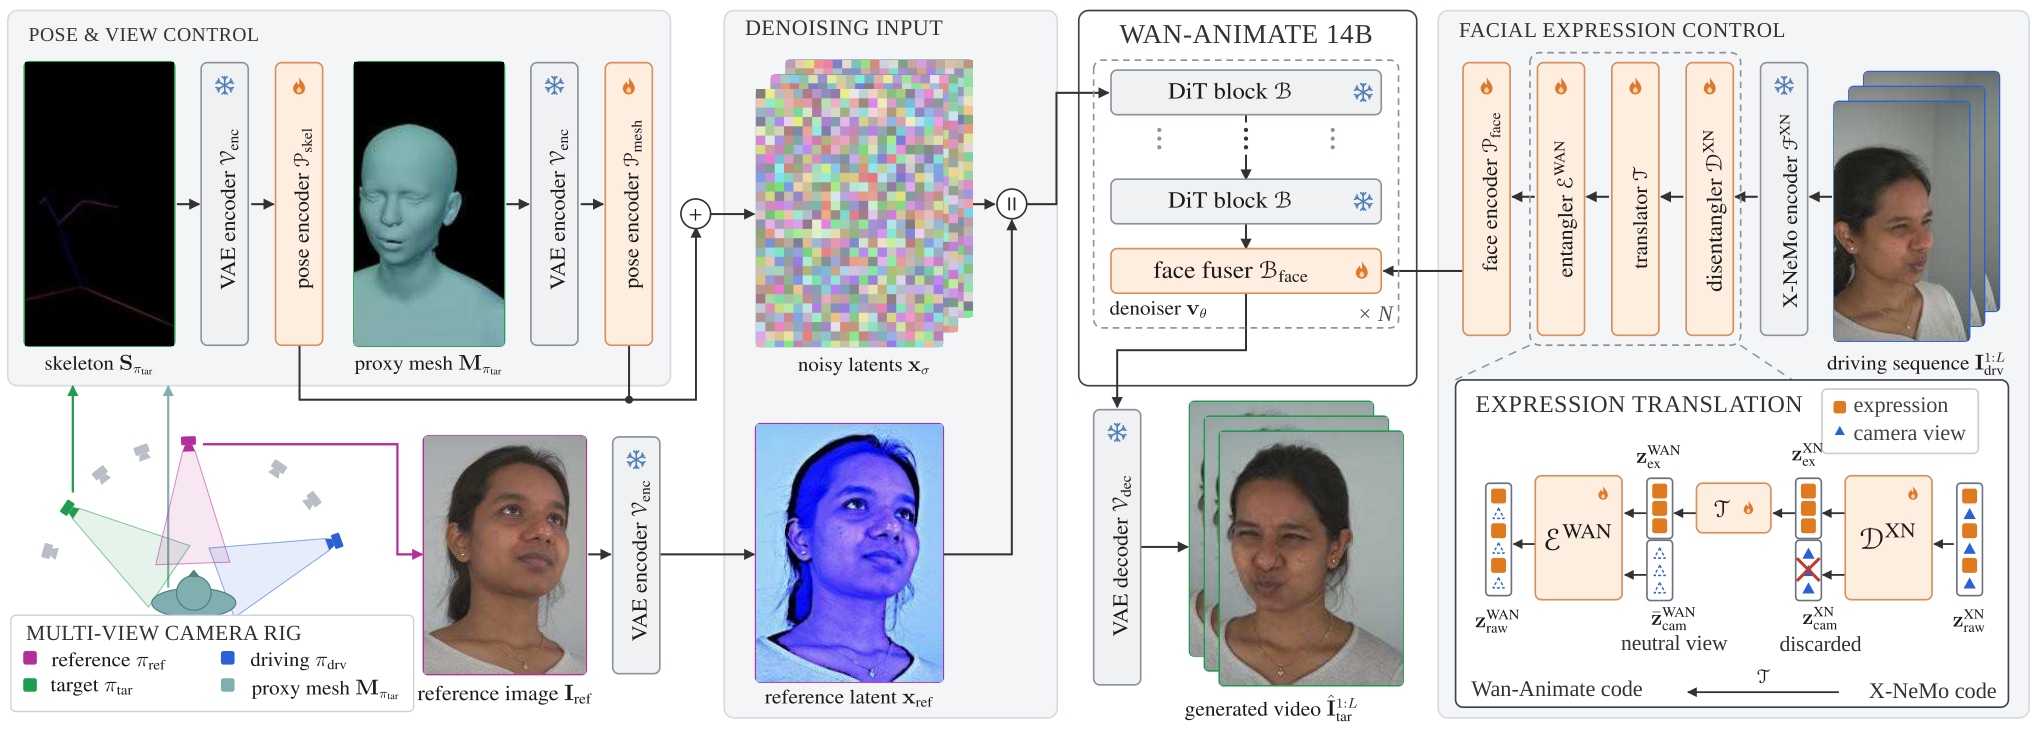
图2将 XNeMo 表情表示输入解耦网络,分别得到表情与相机分量,再通过重建、对比与交换循环约束减少串扰。表情转成生成模型原生条件时使用中性相机表示,尽量不把驱动者镜头运动也复制过去。
- 2
用粗几何提供可控视角线索
FLAME 头部和 SAM3D 身体构成代理几何,按身体部位编码局部射线方向,区分颈部动作与相机变换。代理用于条件控制,不等于最终显式三维重建;坐姿、骨盆锚定等拟合假设仍影响范围。
- 3
以跨视角三元组适配视频先验
参考外观、驱动动作与目标视角组成训练三元组,只微调 Wan-Animate 部分模块,学习在不同视角维持身份与表情。快速版本进一步蒸馏,但速度、分辨率和质量需要分别报告。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据4696段视频、640个身份,来自 NeRSemble 与 AVA256;训练5000步低分辨率加250步高分辨率,报告约34小时 A100 80GB,不包含基础模型预训练。评测含 BecomingLit、Multiface、自驱动和跨身份设置。 数据与训练预算 ↗
我的解读计算时间只覆盖适配阶段,不能据此估算从零训练数字人模型的总成本;采集环境也限制了泛化。
来源证据主表面部 LPIPS 0.202,对照最佳0.282;DISTRACT 表示诊断可从18%提升到98%,但解耦训练看到了该基准帧。多视角高斯拟合探针在13个主体上显示 PSNR 23.69 对23.28。 外观与解耦诊断 ↗
我的解读LPIPS是感知误差,不能写成用户满意度;98%不是严格未见数据泛化,高斯拟合探针也不证明已输出动态可编辑资产。
来源证据完整576p的77帧片段报告约12分钟,附录另有不同计时口径;快速版论文约4.8fps、仓库约3.5fps,使用较低分辨率。仓库提示完整模型至少48GB GPU、快速576p约80GB。 速度与失败边界 ↗
我的解读并非稳定25fps实时视频。光照与反射依赖生成先验,尚无独立 PBR 材质、去光照或一致重光照保证。
开放情况与使用许可
核验到 GitHub 实际推理实现、Hugging Face 完整及快速权重文件。代码与作者权重为 CC BY-NC-SA 4.0,带非商业约束,第三方组件另有条款;FLAME 等前处理仍有独立获取条件。未据此宣称完整训练链已开放或可直接商用。
LICENSECC BY-NC-SA 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
通过解耦驱动与跨视角训练,给数字人表情、身份和相机提供更清晰的控制接口;多视角探针比仅展示正面视频更有意义。
反方 · 哪些结论还不够
中间代理几何不能直接替代最终资产;没有明确 UV、接缝、材质通道与动画绑定交付。解耦诊断存在传导式训练边界,生成可能漂移,运行成本也高。
综合判断
适合作为可控数字人视频和三维外观参考研究;不能当作已经完成生产级头像建模与材质管线。
我会先做的验证
未执行的验证方案:固定身份分别扫描相机、表情和外部光源,测长时间漂移与非正面一致性;尝试提取显式资产后再单独检验 UV 接缝、视角反射及不同光照下误差。