VGC:给生成视频增加后处理几何校正器
画面更连贯,是否也意味着几何更真实?
从真实带位姿视频制造失真对,训练独立视频扩散校正器修复生成序列。重投影指标有所改善,但若干感知指标下降,且公开版本与主实验架构不同。
图解主要方法
画面更连贯,是否也意味着几何更真实?
- 1
按相机运动构造配对训练数据
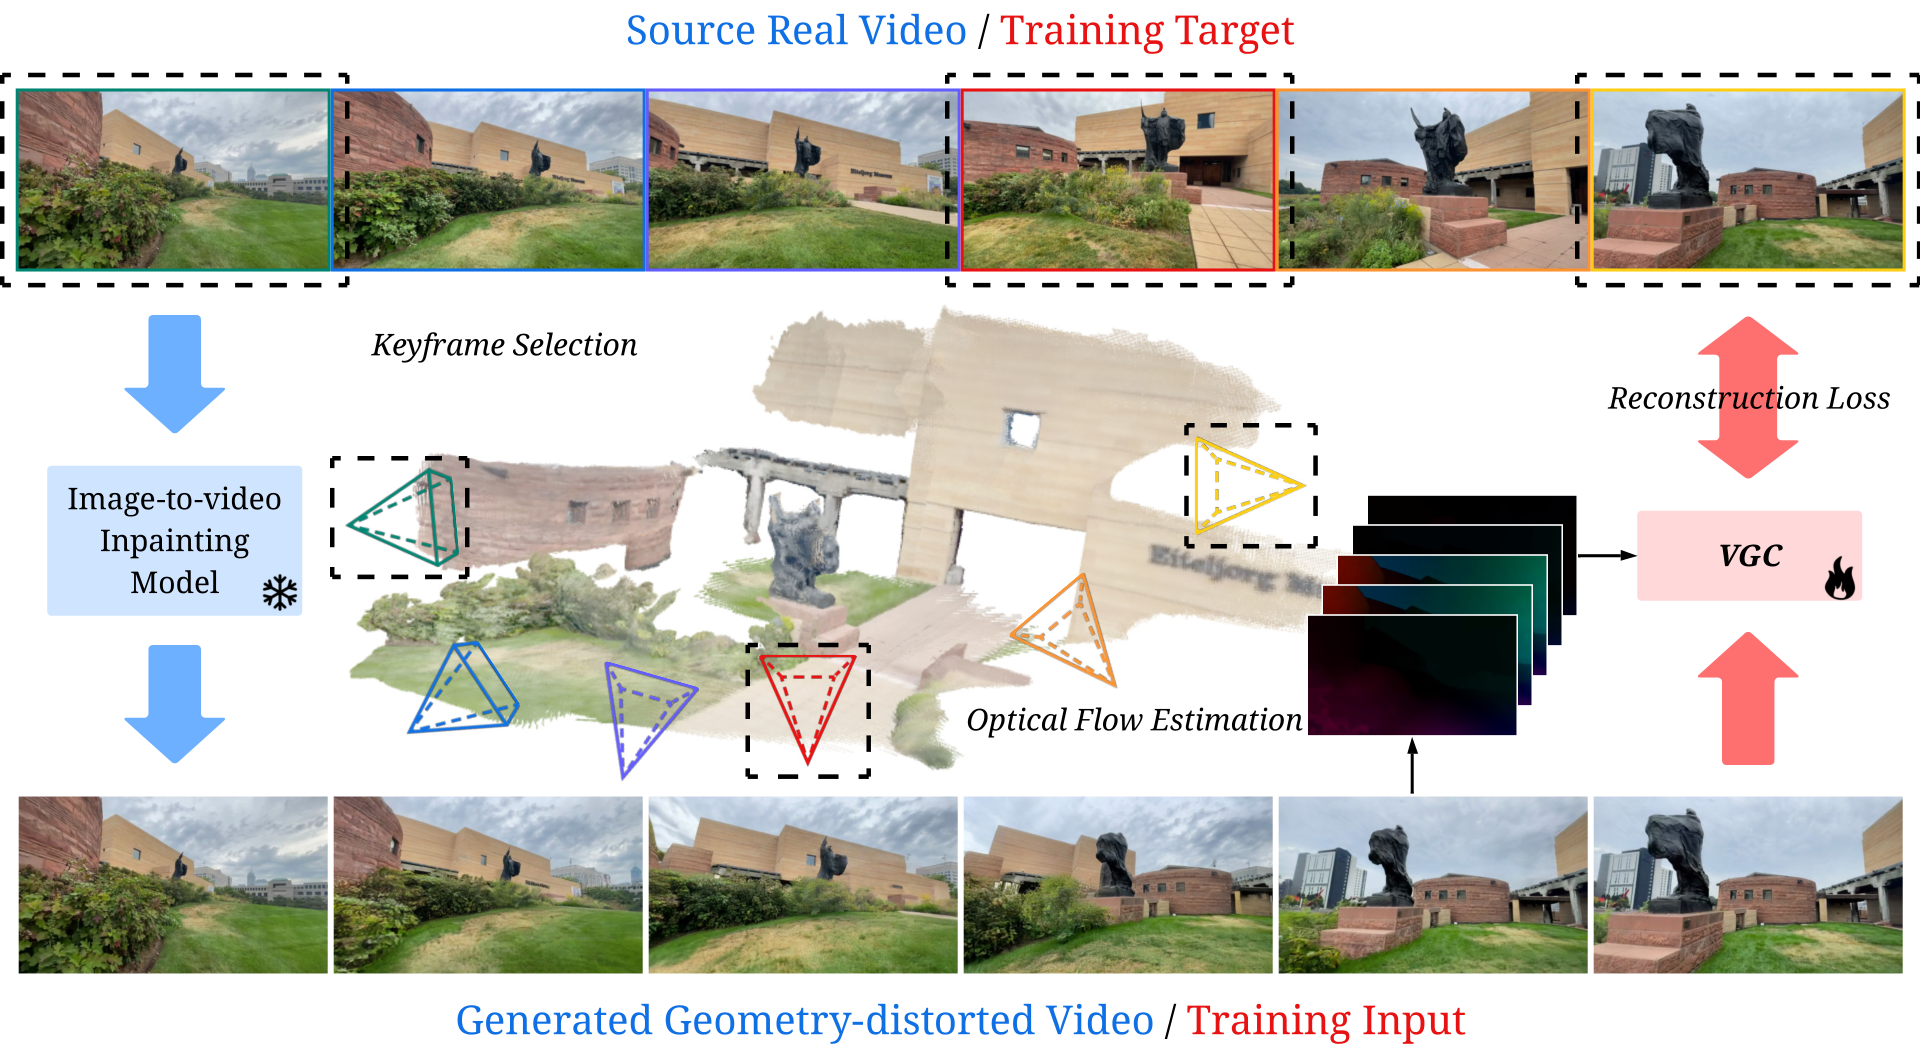
图3从DL3DV和SpatialVID抽取带相机位姿片段,依据运动预算和转折点选关键帧;使用Wan2.1-Fun-InP在关键帧之间生成失真视频,以真实原片作为校正目标。
- 2
训练独立校正扩散器
主实验采用Wan 1.3B,不改原始视频生成器。训练81帧、832×480,最多4个运动分段、120度与10米预算、最小15帧;DL3DV约9k训练保留1k,SpatialVID约63k,32张H100、10k步、batch64。
- 3
用可选光流提示局部运动
SEA-RAFT光流按通道作为条件,帮助保留运动关系。相机位姿用于数据构造;图中的三维重建是可视化评估,并非推理时必须执行的三维修复管线。
- 4
跨生成器测试并核对发布变体
校正器可以接多个视频模型,但公开推理版换成Wan2.2 14B MoE、720p且不使用光流。必须把该实现与论文1.3B、带光流结果分开,不能直接继承全部指标。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据RE100的DFoT结果PSNR从13.61到14.87,重投影误差RVE从184.2到168.9;光流消融PSNR14.76到14.87、RVE169.4到168.9。 几何指标 ↗
我的解读校正确有帮助,但光流本身边际收益小,不能把整体提升都归给显式运动约束。
来源证据表2中I2V SSIM由0.5543降至0.5456,3D一致性指标0.7944到0.8121变差;三个比较的LPIPS分别0.5285→0.5733、0.5449→0.5936、0.576→0.6284,均变差。 感知质量反例 ↗
我的解读正文的概括性正面措辞不能代替逐列结果:几何校正可能牺牲纹理和感知接近度。
来源证据200条DL3DV的自由生成使用DepthAnything3重建后自一致性,而非真实几何;14B还同时从480p升到720p。100条动态SpatialVID没有配对真值;Hunyuan的DOVER10.10降至9.30,美学0.5133降至0.4849。 无真值与升级模型条件 ↗
我的解读预测深度自一致性不等于真实世界正确,超分辨率也混入模型升级比较;不应把所有输出称为物理正确。
开放情况与使用许可
weijielyu/VGC已有实际推理脚本和Apache-2.0许可证;README公开的是Wan2.2 14B无光流版本并给出wlyu/VGC权重链接。未独立完成权重许可核验,不把代码许可扩大到所有基础权重。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
独立后处理使方法能服务不同生成器,配对失真训练为跨帧修正提供了可操作途径。
反方 · 哪些结论还不够
几何、纹理和审美存在权衡;自估深度评测、升分辨率和发布版本差异限制了结论外推。
综合判断
适合用作生成视频的几何修正候选,尚未证明可直接生产度量可靠的世界模型或三维资产。
我会先做的验证
未执行的验证方案:在固定分辨率、同一生成序列上对比有无光流;使用真实相机与深度真值测轨迹、结构和遮挡,同时做盲测纹理损伤与运动保持。