Video2World:重建得像,是否真的能让机器人完成原任务?
把几何、运动与功能分别评分,并审查评测分母和执行条件
编码智能体从单段RGB视频编写场景与机器人控制,在模拟器中观察自己的执行并修正,最终冻结场景—行为包接受隐藏评测。核心问题是可执行交互是否重现,而非仅输出相似视频。
图解主要方法
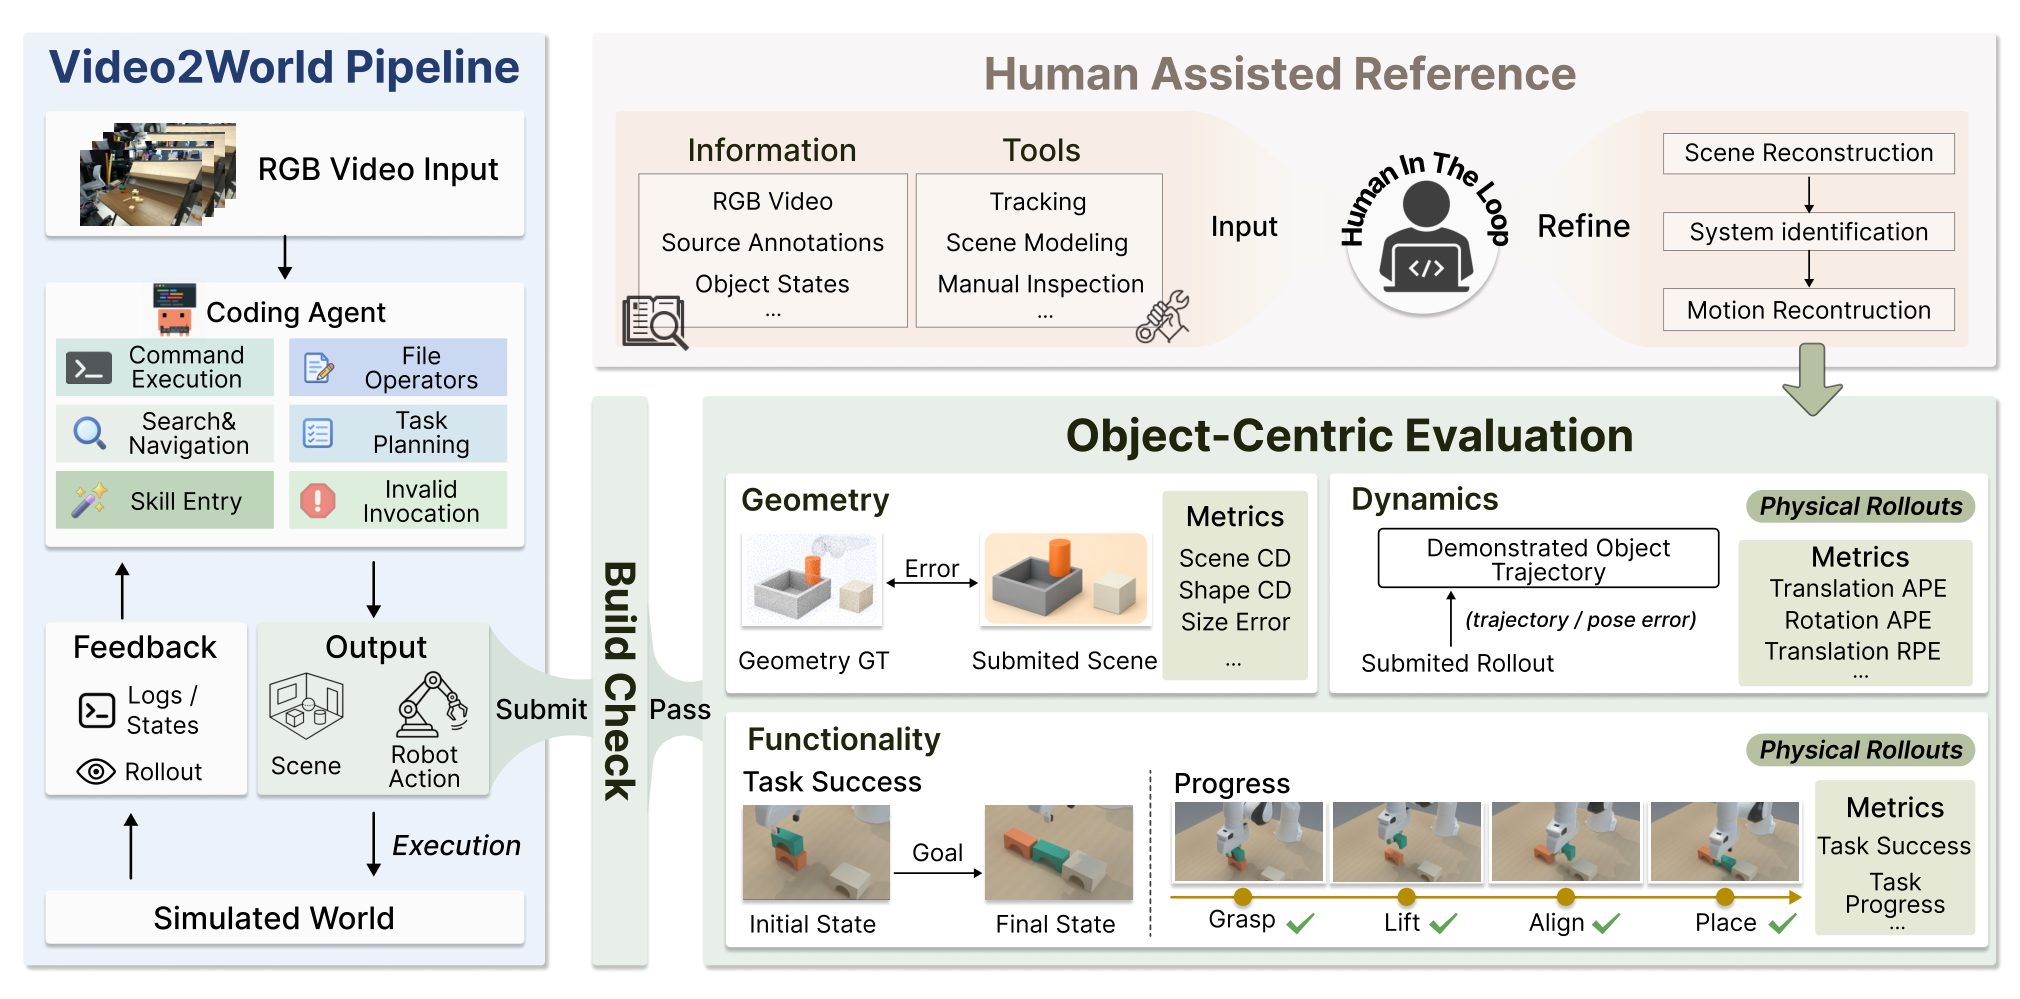
图2为何把Build、几何、动态和功能分开,人工参考又拥有哪些额外信息?
- 1
只给视频与公共工具,允许检查自己的模拟
图2左侧智能体估计形状、碰撞、尺度、初态、相机和有限控制序列。候选回放只反馈自己的日志与渲染,隐藏几何、轨迹和任务分数不回传;只有实际打开的媒体才算观察。
- 2
冻结场景与行为,区分构建成功和任务成功
一轮构建最多180分钟,托管七系统165分钟停止新生成,其余原生CLI保留不同提交语义。检查schema通过只是Build;最终对象必须由机器人和模拟动力学移动,声明轨迹不能当动画驱动。
- 3
沿图2右侧分别检查几何、动态和事件
Scene CD允许受限旋转尺度及自由平移配准,物体尺寸和初始位置另算;平移APE各减初始位置并按演示时间比较,不做时间扭曲。成功还须满足抓取、转移、释放、稳定等对应任务事件,初态已满足目标不能直接得分。
- 4
检查评分分母和场景—行为共适配
V2WScore以Build门控,功能、几何、动态各三分之一,先逐实例归一再按任务族平均。附录交叉执行限定20或44个可迁移参考子集,使用特权初始位置平移的结果只是诊断,不是无特权能力。
实验与证据
已阅读v1完整正文及其公开附录、核对作者实验与必要原图;未独立复现实验。
来源证据正文表2报告最高系统Task Success25.5%、HAR58.8%;附录9.5另列215/179/112样本与HAR57.3%宏平均。 表2 / 附录9.4–9.5 ↗
我的解读这些数字的样本和修订口径未统一,本文保留冲突,不据此宣称确定排名或提升幅度。
来源证据附录Set A中own成功24.3%,参考控制迁入12.1%;智能体控制迁出2.3%,用真值初始位置平移后15.5%。 附录10.1 / 表A14 ↗
我的解读表明初始化与控制匹配重要,但选中的20实例及非完全一致执行条件不足以作严格因果分解。
来源证据人工偏好243次有效判断来自12名内部参与者、39案例;28%判断为两者都差。 附录8.6 ↗
我的解读是总体可见忠实度的相对偏好,不是客观成功率;bootstrap按视频而非独立重采样评审者。
开放情况与使用许可
官方仓库确有v2w评分器、video2sim协议与模拟桥接代码,Apache-2.0;链接外部数据,本次数据页不可访问,未确认全量数据下载和上游资源许可。
LICENSE论文图2为CC BY-SA 4.0;仓库代码Apache-2.0;源视频、机器人资产与数据各自条款仍适用。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
补充交叉执行把同一行为放进不同场景,显示场景与控制可共同适配;端到端成功不等于场景可供任意控制器使用。
反方 · 哪些结论还不够
九个系统使用不同CLI、检查点和细化语义;人工参考能看隐藏标注且执行条件不同,不能将其当同预算人类基线或只排名骨干模型。
综合判断
值得关注的评测方法,但当前版本的分母及参考口径不一致,榜单百分比应带表号和限定条件。
我会先做的验证
未执行的验证方案:固定一个manifest与所有执行条件,重算全部系统的共同样本宏/微平均,再用多个独立控制器和未见布局测世界复用;公布失败与基础设施错误分账。