VideoNeuMat
从视频生成模型里提取可重光照的神经材质
先让视频模型在受控相机和光照轨迹下“观察”一种材质,再从这些视频帧重建可重用的神经材质。7 月发表于 SIGGRAPH;预印本首发于 2 月,本期按会议正式发表补充收录。
图解主要方法
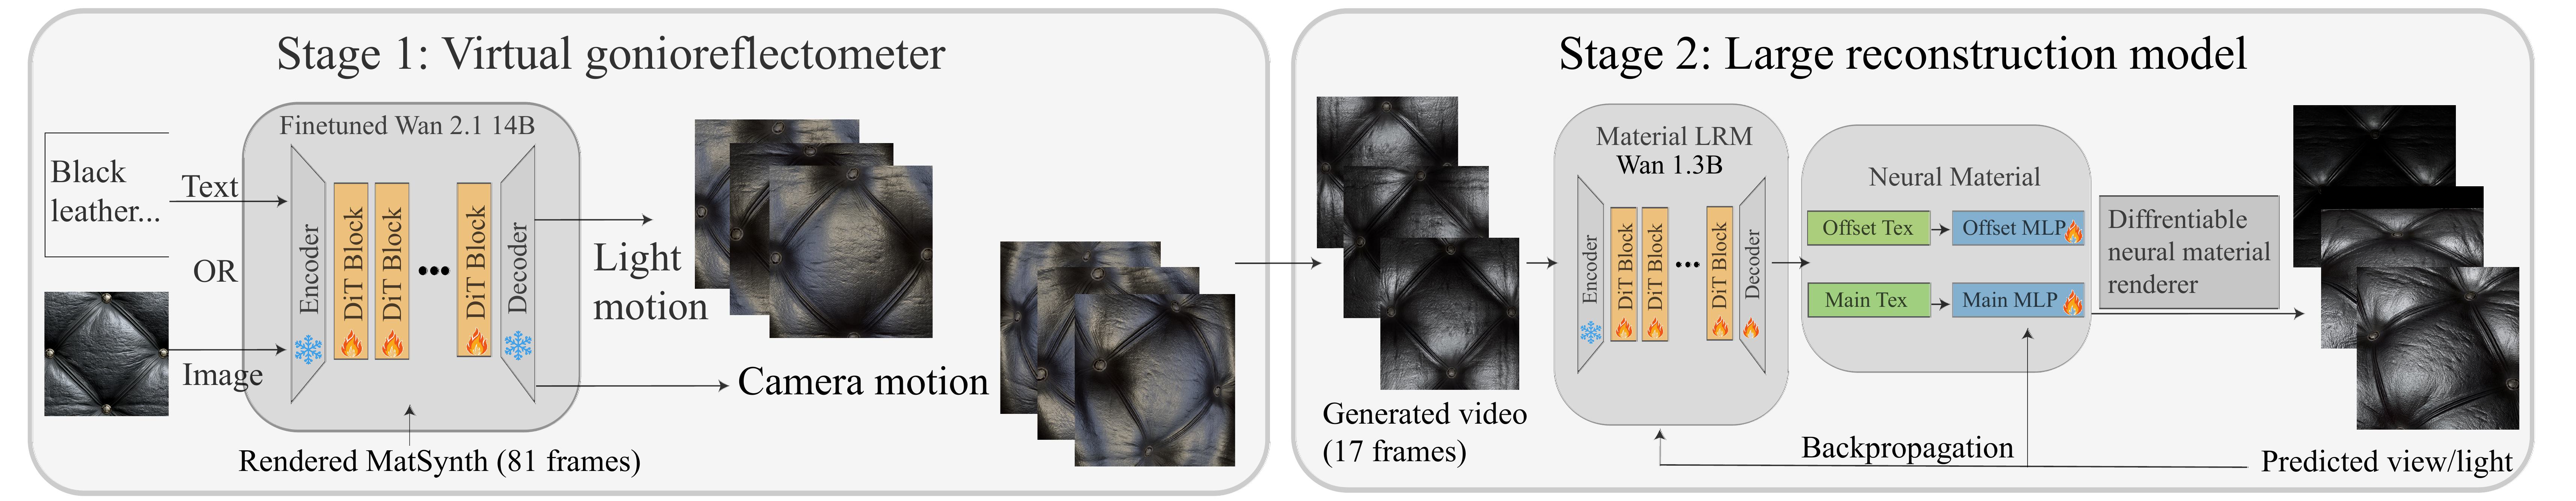
单张“皮革图片”把颜色、凹凸与光照混在一起,很难直接还原为可重用材质。VideoNeuMat 先让视频模型模拟一个受控的测量过程,再把变化中的外观压缩成能重新渲染的材质。图 2 的两阶段分别负责提供观察与恢复表示。
- 1
左半:让视频按测量轨迹生成
文字或图片输入微调后的 Wan 模型,先改变光源,再改变相机。目的不是拍一段任意动画,而是让外观变化具有已知原因:高光随光走、视差随相机走,才有机会区分材质与照明。
- 2
右半入口:从 17 帧提取共同解释
LRM 读入生成视频的 17 帧,预测一组神经材质参数。可以把它理解为寻找一个共同的解释:同一份材质应能同时说明这些观测,而不是为每帧保存一张独立的贴图。
- 3
绿色模块:表示里包含方向相关细节
图中的 Main Tex 与 Offset Tex 配合 MLP 表达材质和视差效果;输出不是直接可替换的几张标准 PBR 贴图。它获得更强表达力,同时把运行时绑定到特定解码与渲染方式。
- 4
最右侧:用重新渲染检验重建
可微渲染器生成不同视角与光照下的图像,训练时把误差反传。这个环节把视频先验接到资产表示上,但输入视频若包含互相矛盾的高光或阴影,重建也只能寻找折中。
实验与证据
论文区分了生成视频的逼真程度、测量轨迹的一致性与神经材质重建误差。它们对应不同问题,应分别读取,而不是汇总成一个“材质更真实”的结论。
论文证据表 1 中,生成视频相对 OpenVid-1M 的 FVD 为 118.04,MatSynth 渲染为 138.86;作者明确将它作为视频分布接近程度的代理指标。 表 1 ↗
我的解读这支持预训练外观先验得以保留的解释,却不证明反射规律准确。一个看起来更像实拍的视频,也可能无法由同一物理材质一致解释。
论文证据表 2 的完整方案在部分重建指标上更好,但线性上采样的 LPIPS 为 0.4497,低于完整方案的 0.4554;41 帧也未全面优于 17 帧。 表 2 ↗
我的解读不要把消融写成“所有模块、越多越好”。应先确定目标指标,再判断增加复杂度是否值得;更多观测若含冗余或不一致,不一定提升资产重建。
开放情况与使用许可
已确认官方仓库链接的 Hugging Face 权重存在;代码仍待发布。首发 2026-02-06,SIGGRAPH 正式发表月份为 2026-07。
LICENSE权重模型卡:Apache-2.0;完整实现许可待发布
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我看好的是“先生成可解释的观测,再重建资产”这个接口。它把大视频模型的丰富外观知识与较紧凑的材质表示连接起来,而不是要求一个模型直接学会所有标准材质通道。
受控轨迹也是很具体的研究抓手:可以分别改变光照覆盖、视角数量和重建容量,定位瓶颈到底来自先验、观察协议还是材质表示。
反方 · 哪些结论还不够
但生成的测量不是实测真值。视频模型可能在帧间改变微几何或高光规则,重建器再把这种不一致压成看似合理的平均结果;视觉逼真与物理可解释之间仍有缺口。
神经材质的可用性还取决于目标渲染器、着色成本和烘焙误差。只有权重而缺完整实现,也不能把这条链路当作随时可复现的生产工具。
综合判断
这是我会优先跟进的材质研究路线,尤其适合探索视频先验如何变成资产。但如果你的目标是立即输出游戏引擎 PBR,必须把转换成本作为主要指标,而不是附带步骤。
我会先做的验证
为同一材质保留训练外的相机—光源组合,分开测试视频生成、LRM 重建和最终烘焙。比较同观测数量下的标准 SVBRDF 与神经材质,记录高光轨迹、视差、平铺接缝及目标引擎帧耗时;不要只比较输入帧的重渲染。