WAVE-0:让预测的动作后果真正进入策略推理
潜在世界模型只是训练辅助,还是能在执行时帮助选择动作?
WAVE-0在π0.5中接入257M参数的潜在世界模型:先用真实动作学习未来特征,再让VLM规划出的潜在动作经世界模型变成未来条件。它不用生成视频像素,但完整策略仍约4.3B,且预测误差与真实控制可靠性不能画等号。
图解主要方法
潜在世界模型只是训练辅助,还是能在执行时帮助选择动作?
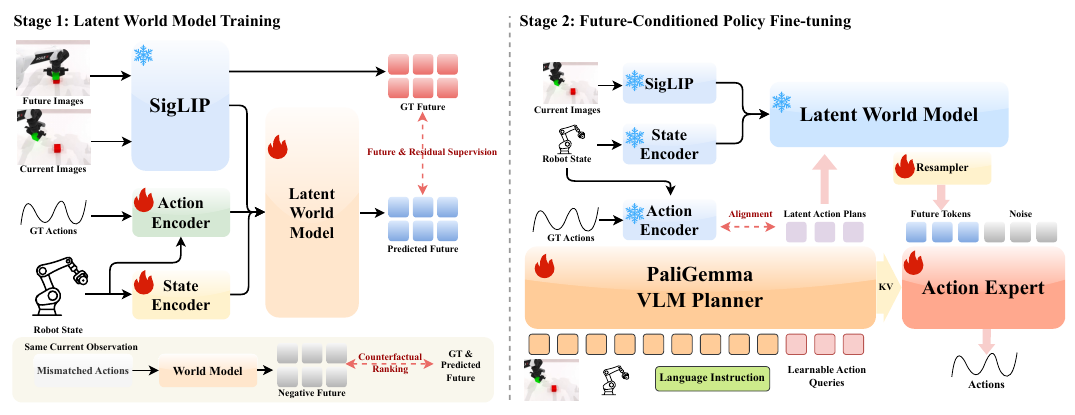
- 1
在冻结视觉空间学动作后果
冻结π0.5的SigLIP与投影器,将每相机特征池化为4×4网格。动作编码器读真实动作块与本体状态,12层Transformer以AdaLN条件预测特征残差,再加回当前表征。未来余弦距离与残差SmoothL1共同监督。
- 2
用错配动作防止忽略动作输入
保持观察和状态固定,替换为不同动作序列;排序损失要求真实动作对观测未来的距离至少比错配动作小0.1。它检验对动作的敏感性,但未观测错配动作实际发生后的未来,因此不是完整反事实动力学校验。
- 3
对齐VLM潜在计划与动作编码空间
第二阶段冻结世界模型,训练VLM的可学习查询产生潜在动作,并对齐冻结动作编码器输出;同样以未来和残差目标约束计划。世界模型把计划转换为未来视觉特征。
- 4
经预测瓶颈给动作专家条件
resampler把预测压到每相机2×2网格,未来token与噪声动作共同进入专家;专家仍可读原VLM上下文,但排除潜在动作查询,防止计划分支绕过世界模型直接传信息。图2的冻结标记明确区分两阶段参数更新。
实验与证据
已阅读17页PDF全文,包括附录A.1–A.4、逐任务表与实机配置,核对实验条件与原图;未独立复现。
来源证据π0.5为80.38%,仅世界模型辅助监督89.51%,完整WAVE-0为91.47%;LIBERO为98.7%,相对π0.5多1.8点。 表1:RoboTwin50任务、各两种设置100回合 ↗
我的解读多数提升已由辅助监督带来,推理时未来条件额外约1.96点;RoboTwin并非全表最高,ImageWAM93.38等仍更高。
来源证据LIBERO-Plus88.0、Pro61.4;噪声扰动80.6低于π0.5的84.3。去排序项后Plus85.4、Pro58.4,20k步动作距离差从0.0020增至0.1648。 表2、图4:泛化和目标消融 ↗
我的解读均值改善不代表所有扰动更稳;距离差是对同一真实未来的排序指标,不是生成未执行动作后果的准确率。
来源证据每项200演示、20测试回合,成功均值38.3→73.3;WAVE世界模型预训练使用全部600演示,任务策略分别微调。 表3及附录A.2:三项实机任务 ↗
我的解读60次试验支持有限场景改善,未给出多训练种子区间。USB任务实际为放入容器,不是电子接口插接;各基线动作块和执行长度也不同。
来源证据服务器平均延迟π0.5为287.1ms、WAVE305.9ms、LaWAM223.9ms;RoboTwin约670 H100 GPU小时。 附录表11与训练配置 ↗
我的解读世界模型增加18.8ms而非加速原π0.5;257M只指新增模块。与更小LaWAM比较需同时考虑模型规模、动作长度和预训练费用。
开放情况与使用许可
官方仓库已有LeRobot扩展与训练脚本,代码Apache-2.0。官方Hugging Face的WAVE-0-LIBERO仓库已有model.safetensors等权重文件且未设访问门槛,但模型卡为空、未核实明确权重许可,不能自动套用代码许可。论文及原图采用CC BY-NC-SA 4.0。
LICENSECC BY-NC-SA 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把真实动作监督与部署时预测瓶颈结合,并通过仅辅助监督对照检验未来条件的额外贡献,设计清楚。
反方 · 哪些结论还不够
固定SigLIP表征可能遗漏精细接触与动力学;错配动作排序不提供真实反事实标签。实机样本小,训练数据共享与超参数不同,缺少长时闭环误差和多种子统计。
综合判断
是轻量潜在世界模型接入强VLA的实用方向,但“轻量”应相对于新增世界模型和视频生成成本理解,不能说完整系统只有257M或无需预训练。
我会先做的验证
未执行的验证方案:固定策略训练预算与数据,增加动作打乱、伪未来和仅额外容量对照;在真实执行不同动作后采集未来验证反事实预测,测接触失败恢复、尾延迟和多种子成功率。