The Weight Is Over:让图像生成更接近本地交互
小文本编码器、量化和权重流式加载各解决不同瓶颈
论文以 FLUX.2-klein 为例,组合小编码器加翻译器、低比特计算和按层权重流式加载,降低本地图像生成成本。它属于视觉资产流程的基础能力;重点要区分编码耗时、首轮预览和完整成图,以及显存节省与质量损失。
图解主要方法
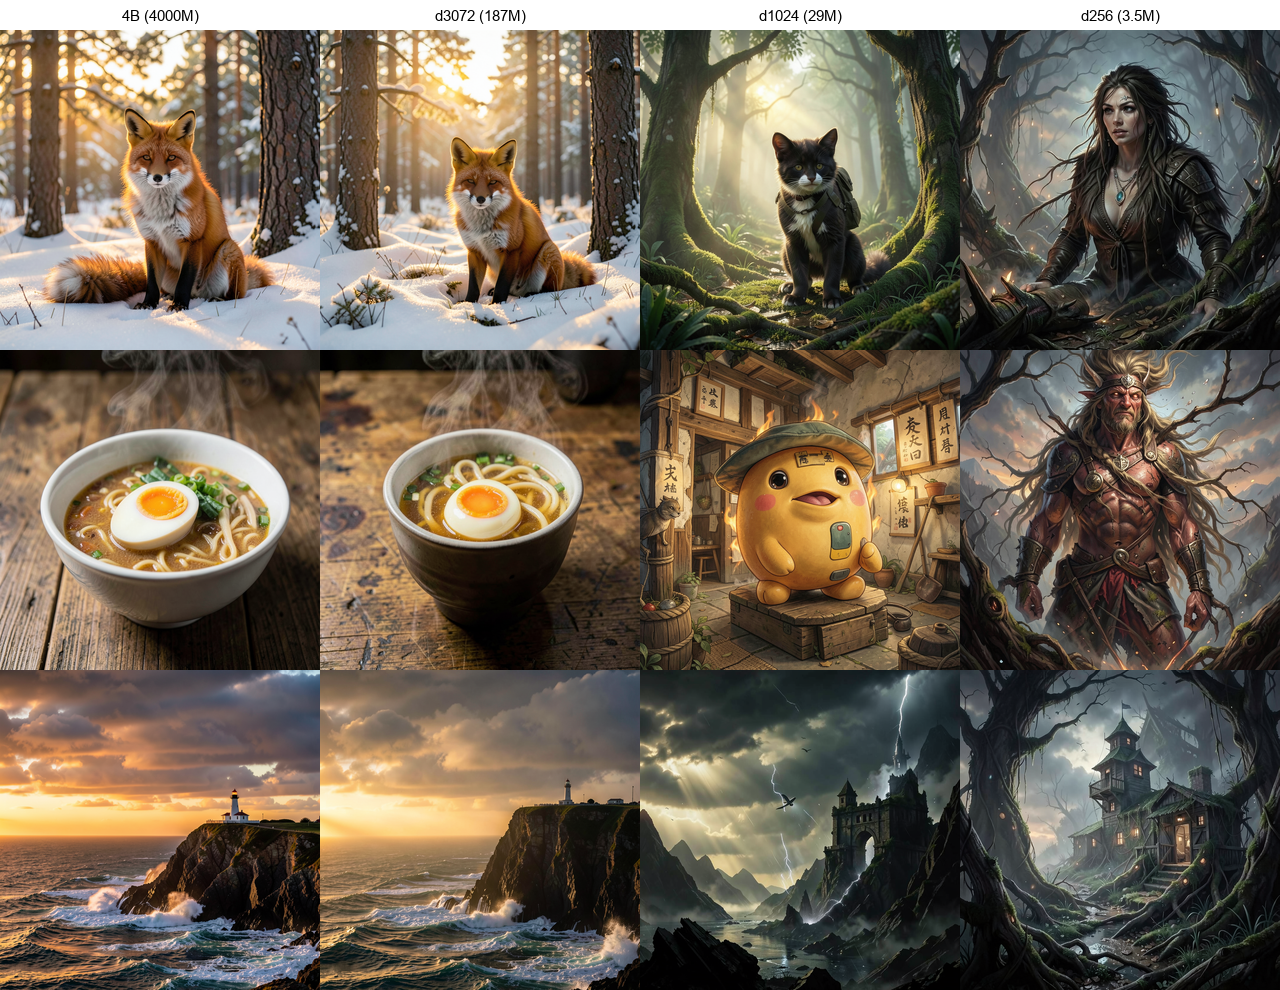
为什么图 2 的小翻译器会改变主体,压缩与流式加载又怎样影响交互?
- 1
先压缩文字条件,而不是重训整个扩散模型
将原 4B Qwen 文本编码器替换为 Qwen3-0.6B,再用后训练翻译器回归教师逐 token 特征。共享 tokenizer 保持对应,扩散 Transformer 与 VAE 冻结。这里小模型的语言能力不足可能通过条件表示影响最终图像,即使生成主干完全不变。
- 2
图 2:看容量缩小如何改变语义
四列依次为 4B 教师、187M、29M、3.5M 翻译器设置,同提示与种子下比较狐狸、拉面和灯塔。187M 更接近原意,后两列出现主体或风格漂移;特征相似并不足以保证图像语义正确,不能只用隐藏特征回归误差选模型。
- 3
量化权重与量化激活解决不同问题
仅压权重主要省驻留显存;FP8/NVFP4 激活计算还依赖硬件支持以加速矩阵乘。较低精度会改变输出,必须结合内容分布评估;设备不支持对应路径时,标称位宽不自动兑换成速度。
- 4
按层流式加载把一部分权重留在主机内存
从锁页主存搬入将要执行的层,与当前层计算交叠。相同精度下可保持计算结果,省的是 GPU 驻留,不是整机 RAM;最少缓冲仍包含两份最大层权重和激活。PCIe 与算力平衡决定传输能否隐藏,统一内存机器不一定适合这条路径。
- 5
把首轮预览与完整四步生成分开
论文 TTFI 包含编码、一次去噪迭代和解码,并不等于四步全部完成。较小编码器在 M3 Max 上可明显减少编码时间,但 TensorRT GPU 上原编码已经很短,主要收益转为省内存。交互指标应包括完整成图以及冷启动/编译成本。
实验与证据
以下实验均为作者报告,本站已阅读论文正文及可用附录,未独立运行研究实验。实验条件、观察结果与编辑解读逐项分列。
来源证据【表 1】24 条 PartiPrompts、1024²评估中,187M 翻译器 CLIPScore 0.306,4B 教师 0.328;LPIPS 0.514。 §3,表 1 ↗
我的解读样本少,且同种子输出并非严格空间对齐;LPIPS 不能单独衡量语义,原图中小翻译器的主体漂移值得专门测试。
来源证据【表 2–3】M3 Max 48GB 上编码约 435ms→107ms、编码权重约 8GB→1.77GB;RTX PRO 6000 Blackwell 上一组 NVFP4 设置峰值 5.7GB、TTFI 102ms、完整四步约 0.27s。 §3–4,效率表 ↗
我的解读两个设备、两类指标不能拼接成普通消费卡的统一成绩。论文 RTX 4070 Ti 12GB 的部分驻留设置完整生成约 3s。
来源证据【§4】NVFP4 相对 BF16 的图像 CLIP 相似约 0.92±0.08、LPIPS 0.23±0.09;同精度权重流式加载可保持输出一致。 §4,精度与流式加载 ↗
我的解读量化是近似,流式加载是存储调度,二者质量性质不同。若在高频纹理和文字上失败,仍可能抵消等待时间节省。
开放情况与使用许可
已核实 NVIDIA/din-deploy 有 FLUX.2 导出、量化与原生推理实现及 Apache-2.0 LICENSE;尚未核实论文小编码器翻译器权重和全部实验设置的独立发布,不能说整套研究组件全部开放。
LICENSE论文 CC BY 4.0;din-deploy 代码 Apache-2.0;模型与依赖分别遵守各自许可,代码许可不替代模型授权。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
三类优化针对条件编码、计算精度和驻留内存,便于按设备瓶颈组合,而不必重训整条生成主干。
反方 · 哪些结论还不够
压缩条件编码会丢失主体语义;以高端 Blackwell 的首轮迭代速度概括消费级完整生成会夸大收益。
综合判断
实用的图像生成部署研究,资产质量与硬件条件必须和速度一起报告。
我会先做的验证
未执行的验证方案:固定模型、种子和分辨率,在目标显卡分别开关翻译器、量化和流式加载;测完整四步 p50/p95、显存及主存,并用文字贴花、重复纹理和局部编辑任务盲评返工量。