World Agent:世界状态正确,不代表事件因果和长期推演正确
用可执行世界分开测量维护、规则演绎、闭环预测和反事实
World Agent将世界能力拆成两条评测线:把连续叙事维护为结构化、可审计的世界,以及在确定性引擎中预测状态变化。它不评画面是否逼真,而是检查事件发生、先后依赖、并发关系及行动后果。多模型能维持部分表面状态,却仍会丢失事件链和长时预测。
图解主要方法
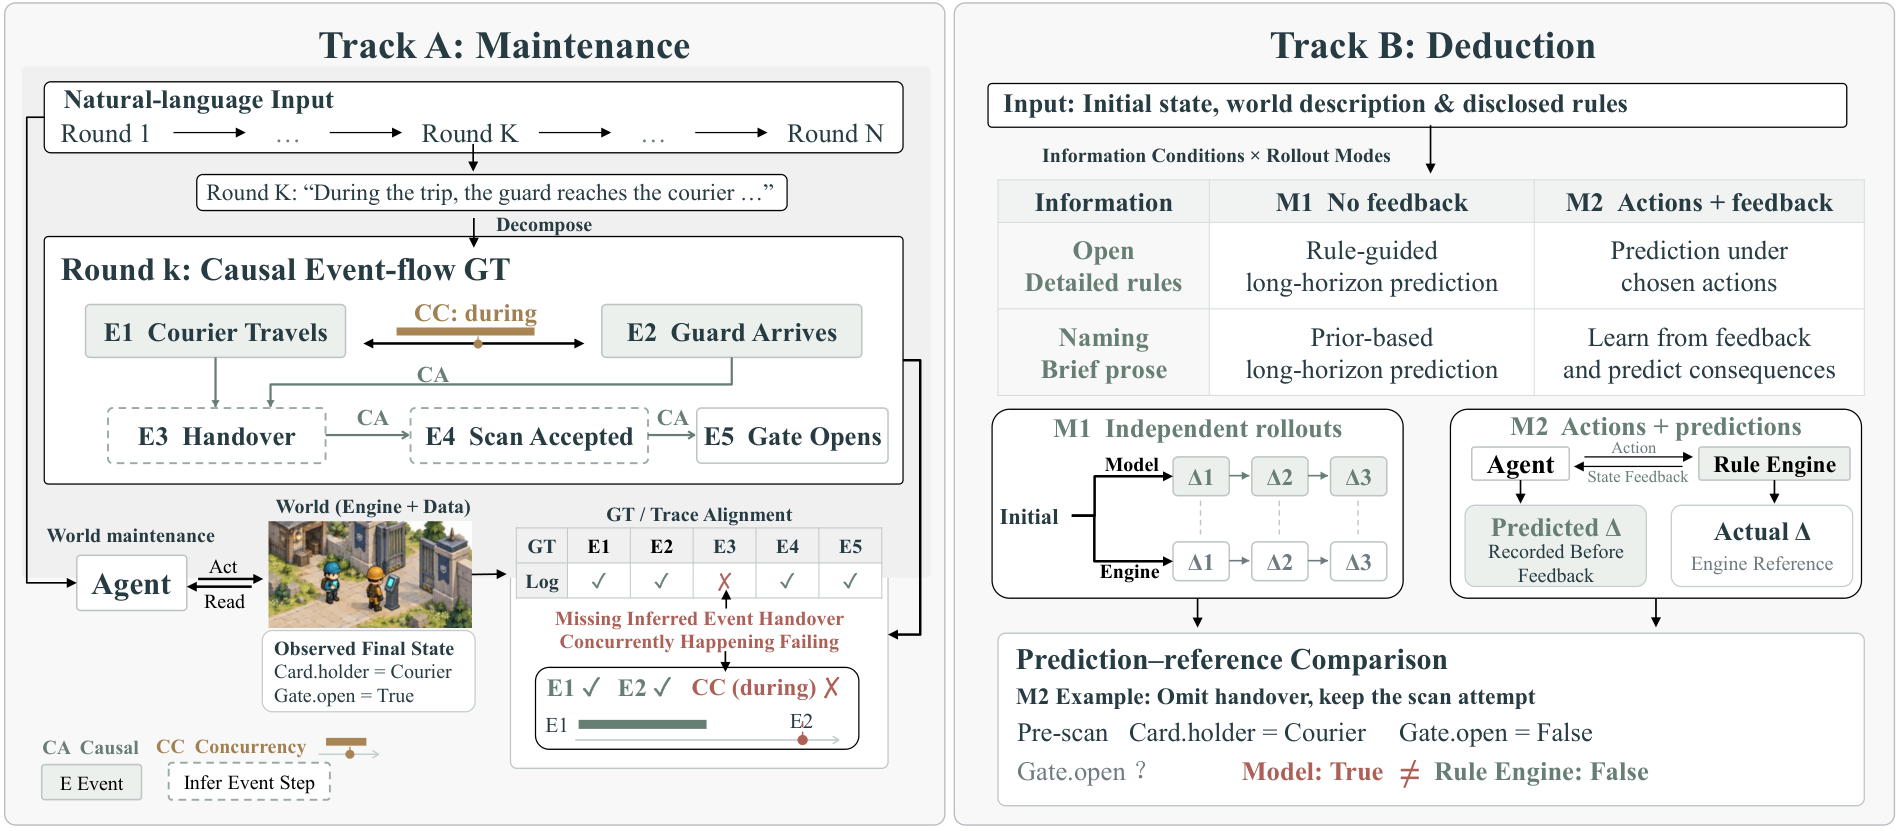
图2如何区分“维护一个世界”和“预测一个世界”?
- 1
维护线:把叙事落到带日志的世界
图2左侧将逐轮文字转成实体、属性和可执行规则。所有写入经工具及引擎检查;同一批提交表示并发,依赖动作要拆成不同步骤。维护引擎不会替模型自动安排所有背景事件,模型必须主动维持世界。每轮冻结状态与日志,后续补写不能修复先前漏掉的事件。
- 2
检查事件链,而不只看最后快照
图中快递员仍持卡而门已开,缺失交接也可能留下貌似合理的结果。评测先绑定本轮真实事件,再分别检查因果依赖、时间次序和并发。完成分由语义裁判与程序审计决定,关系分由程序计算,二者不合成总分。这里“因果”是预先编写的事件依赖及时间约束,不是从数据中发现因果结构。
- 3
演绎线:控制规则披露和反馈
右侧Open提供明确规则,Naming只给定性背景;M1模型独立滚动预测,没有中间纠错,M2先提交行动及预测再接收引擎反馈。演绎引擎会推进时钟、NPC和背景过程,目标是完整区间的字段变化,不只是所选动作的直接影响。用字段路径及精确终值计算F1,空变化样本不能简单充作全对。
- 4
区分远期预测与反事实回放
前瞻检查未来48个时间单位的计划结果;反事实替换过去一个动作,再重放随后记录的命令而不重新规划。图中省去交接仍尝试刷卡,规则引擎判断门不开。这是受控的程序世界参照,不证明现实环境中同样准确;基于同一引擎的oracle检查也只能保证内部一致性。
实验与证据
已阅读v1完整正文及附录A–G,检查图2及当前仓库文件树和引擎接口。以下实验来自论文,本站未复现。仓库与论文接口已有差异,不能直接把当前代码等同于论文运行版本。
来源证据【评测规模】维护31案例、3档难度;三种模型完整运行93次,其余模型主要使用经参考模型结果筛选的9案例子集。演绎6家族×2披露条件×2模式×5折为完整120次,部分模型只有单折。 第4–5节、附录D/E ↗
我的解读我的解读:不同样本规模不能直接排名;9案例子集不是随机抽样。跨难度构建目标的分母也变化,分数下降不等于完全相同题目变难。
来源证据【维护结果】Qwen3.8 Max在共同子集报告完成0.813、关系0.738;多数模型完成约0.69–0.75。Extreme的因果关系跨模型平均0.356,Easy为0.683。 表1、难度分解与附录结果 ↗
我的解读我的解读:较高完成分能掩盖关系错误,但因果并非每个难度下都最弱;构建能力在Hard也很困难。不能把所有错误归结为一种缺陷。
来源证据【演绎结果】所有模型48单位前瞻F1低于0.25,最高0.225;M1在Open与Naming差距明显,例如Qwen Max约0.67与0.15。闭环M2多数改善。 表1、附录E.2及演绎协议 ↗
我的解读我的解读:反馈有帮助,但Naming隐藏参数而M1无法查询,存在不可识别性。部分模型采用不同场景变体和框架,当前结果不足以隔离模型本身的贡献。
来源证据【稳定性与可审核性】完整维护运行中DeepSeek未出现定义内脱轨,Qwen Flash有7次;作者保存逐轮快照、绑定和结算记录。 脱轨分析、附录F/G ↗
我的解读我的解读:平均分与连续运行可靠性需要分开。能够重算结算不意味着语义裁判一定正确;应固定引擎和案例版本,另外人工审核绑定与错误类型。
开放情况与使用许可
核查提交983a6ef:仓库包含维护与演绎引擎、案例、评分器及批处理代码,不只是README;完整递归文件树未发现LICENSE。README当前列出七个工具,新增simulate_step,而论文正文列六个,复现必须固定版本。播放、渲染和可玩演示仍列为待办。
LICENSE实现文件可访问,但未确认授权许可,不称为可自由复用的开源项目。论文为arXiv非独占托管许可,图2仅用于必要方法评论,版权归作者。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把最终状态、事件触发与关系约束分开,能揭示“门开了但交接步骤缺失”一类快照检查漏掉的问题。确定性引擎也允许审核预测与真实变化。
反方 · 哪些结论还不够
Naming条件隐去数值规则且M1不给反馈,部分问题本身无法唯一确定;低分不能全部归因于缺乏世界理解。小样本及场景变体也削弱跨模型归因。
综合判断
有价值的世界运行评测框架,尤其适合暴露事件链与长期一致性缺口;它测量的是人工规则世界中的执行和推演,不等于通用因果发现能力。
我会先做的验证
未执行的验证方案:固定同一案例变体、引擎提交、工具接口、运行框架和预算;盲审一批语义裁判绑定,分别报告状态正确率、事件关系、崩溃率及各时域预测。对Naming额外披露关键数值,检验失败有多少来自信息不足。