World-in-Context:把视角、动作和相机放进同一个上下文
显式视角与累积控制变换如何帮助交互视频切换观察方式
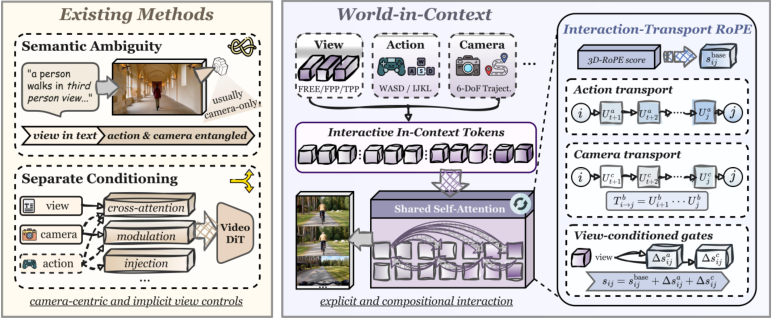
交互视频中的“前进”会随第一人称、第三人称与自由相机而改变含义。World-in-Context将视角类别、动作和相机控制统一为上下文token,再用Interaction-Transport RoPE把沿时间累积的控制关系写入注意力;输出仍是生成视频,尚非可验证物理状态。
图解主要方法
显式视角与累积控制变换如何帮助交互视频切换观察方式
- 1
图2左与中:先消除控制语义混杂
明确标记Free、FPP、TPP视角,把离散动作及连续相机位姿编码成独立槽位;相机用相对六自由度与Plücker射线表示。相同动作在不同视角下如何影响画面,由显式条件而非含糊文本承担。
- 2
图2中:共享自注意力处理多种控制
In-Context Conditioning把控制token和视频潜变量置于同一注意力空间,支持动作单独、相机单独或联合控制。系统沿Wan2.2-TI2V-5B扩展,训练适配部件;统一表示不意味着所有训练样本都拥有完整独立控制标签。
- 3
图2右:把累积控制送进位置关系
IT-RoPE分别构造动作、相机分支的有序正交变换前缀,用两个时刻前缀的相对关系调制注意力。变换不必交换,因而可以保留顺序差异;视角门控和零初始化让新增路径从温和扰动开始,而不是直接覆盖原视频模型。
- 4
长序列:历史槽与最近窗口
后续因果版本保留历史sink及最近token,在分段生成时维持上下文;视角切换另外使用少量转换样本训练。能生成回到旧场景的片段,不等于已验证永久记忆、物体守恒或可供机器人规划的状态转移。
实验与证据
已阅读正文及附录A–B,核对实验条件与原图;未独立复现。
来源证据289个案例、1,058轮测试,导航平均81.5,对照Echo 22B为81.6;视角切换成功93.8%。模型基于5B骨干。 WBench主表:分清导航和切换 ↗
我的解读切换是突出结果,普通导航不是全面领先;跨方法的数据和预算不完全相同。
来源证据加入500条视角转换样本后切换为93.8%;无转换样本的显式视角为37.5%,隐式文本方式为6.25%。 切换数据消融 ↗
我的解读显式表示有帮助,但高切换成功率依赖额外转换监督,不能写成完全涌现的零样本能力。
来源证据切换训练前的消融中导航80.5→81.2、交互86.2→86.8;因果版本导航81.2、切换90.6。 IT-RoPE与因果版本 ↗
我的解读位置机制的边际收益较小,且不是主表81.5所在同一训练阶段;不能把不同表的增益直接叠加。
来源证据训练含约10万导航序列,动作大量由ViPE相机轨迹反推;主要游戏场景来自CS2,含跨地图和现实风格起始图测试。 数据与外推条件 ↗
我的解读反推控制并非独立真实动作测量;游戏视频迁移不足以证明现实物理或机器人闭环可用。
开放情况与使用许可
官方GitHub当前只有README、LICENSE和assets,TODO明确代码及WiC权重仍在审核。安装和运行命令是计划发行说明,不能作为已存在实现的证据;Apache-2.0文件也不改变这一状态。
LICENSE论文与所引原图:CC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:明确区分“谁在看、谁在动、相机怎么走”,能减少交互视频里动作含义随视角漂移的问题,适合作为可控场景原型的表示研究。
反方 · 哪些结论还不够
切换成功依赖监督样本,评价仍以画面和指令响应为主;缺少长期实体状态、碰撞、尺度和真实闭环验证。代码与适配权重尚未开放,复现门槛仍高。
综合判断
值得跟踪交互视角控制;不宜把流畅切换描述为已经形成可规划的三维世界状态。
我会先做的验证
未执行的验证方案:固定初始场景和动作路径,循环切换第一、第三人称后回到原视角,分别测地标回环误差、物体数量守恒、相机响应和生成延迟;与等数据ICC无IT-RoPE版本配对。