World in World:把视频证据接入冻结世界模型
回顾补收:注意力证据、相机控制与开放模块的边界
World in World 将源视频、深度和目标相机轨迹转成冻结模型内部的视觉 KV 证据,让新视角生成尽量依附原事件。它还提出人体代理与长期记忆,但当前仓库只发布部分流程,视觉一致性也不能代替真实三维或物理正确性。
图解主要方法
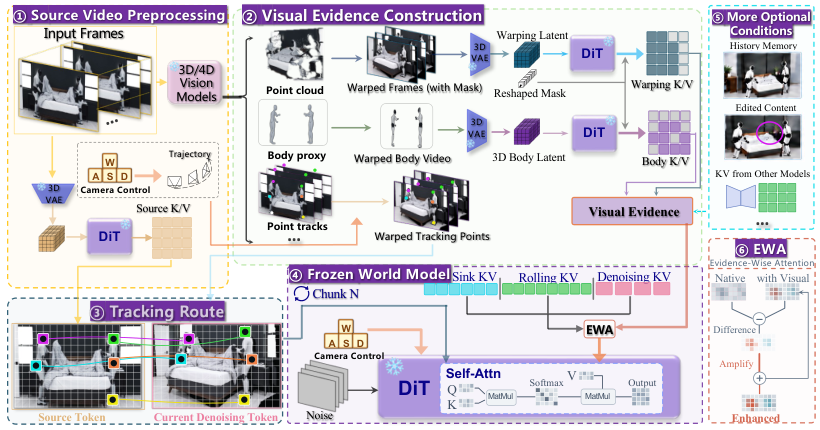
图 2 如何将深度重投影和历史记忆变成同一种注意力条件?
- 1
把原视频重投影到目标相机
源帧由深度升为点云,再按目标相机重投影,附带可见性与可靠性掩码。论文使用人体代理补充大视角结构,但不可见表面仍是模型先验提出的假设,不是摄像机实测到的事实。
- 2
编码成临时视觉 KV 证据
在冻结 LingBot-World 2 的干净状态编码中提取每层键和值,连同位置、时间和可靠性接入注意力。原生窗口保留源帧、近期帧与当前生成块;临时证据每块结束移除。额外引导不增加完整去噪步,并不表示深度和证据编码零成本。
- 3
用对应关系与差分注意力控制强度
CGAR 为持续跟踪的同一点增加注意力对数偏置。EWA 比较证据输出与原生输出,去除重复方向、按一致性加权并限制幅度,减少证据覆盖模型原有计算。对应关系错误仍可能把错误几何稳定地传播下去。
- 4
从历史视锥挑选可见记忆
被滚动窗口移出的视觉特征按相机位置归档,以覆盖率和视角差异选出有限记忆块回读。限制每次注意力读取量不代表归档总量固定;论文共享记忆演示是在相同冻结模型的不同实例之间。
- 5
明确论文与当前实现的差别
仓库已有重拍、子弹时间、视频编辑及可选对应注意力。人体代理、跨实例记忆共享、长期视锥记忆、交互流式和动作迁移仍在路线图中,不能用论文全功能列表描述当前下载即用能力。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【DAVIS/OpenVid】七项 VBench 均值 85.192,对照 UniWorld 84.295;旋转误差 2.8326 对 4.1958,但 LPIPS 0.121664 对 0.121668 几乎相同。 主实验表 ↗
我的解读我的解读:指标衡量视觉与估计轨迹一致性,多个深度/姿态估计器参与评分,不是真实物理轨迹的统一真值。
来源证据【DAVIS 消融】去掉重投影时平移误差 0.581847,完整 0.053291;旋转 6.1158 对 1.7823。 消融表 ↗
我的解读我的解读:几何证据贡献明显;EWA、CGAR 较小差异仍需多种子与区间支撑,不能只展示最佳片段。
来源证据【发布设置】README 测试于 80 GB A100、峰值约 72 GB;15 个 16 帧块约五分钟,长时交互尚未发布。 仓库 README ↗
我的解读我的解读:网页流式演示不能当成该下载版本在单卡实时运行;背离原视角的大幅转动需生成不可见内容。
开放情况与使用许可
已打开 WorldinWorld 仓库、对应注意力实现和 README。核心重投影编辑代码可用,根许可 CC BY-NC-SA 4.0;多个论文模块仍未发布,底座与第三方模型分别适用自己的条款。
LICENSE项目代码 CC BY-NC-SA 4.0,底座与第三方依赖另计;不是无条件商用发布。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
让源证据与生成模型使用同一注意力接口,便于分别控制可见区域、相机轨迹和历史读取。
反方 · 哪些结论还不够
深度、人形和跟踪误差会被带入生成;长期记忆多为定性演示,仓库公开范围小于论文。
综合判断
当前更适合有源视频约束的有限角度重拍与编辑;不能按任意场景数字孪生或完整交互世界来验收。
我会先做的验证
未执行的验证方案:使用有标定多机位真值的视频,分别测可见区保真、不可见区几何与回访漂移;把预处理、KV 存储和生成耗时纳入总预算,并对未发布模块另行复现。