文字世界模型该微调还是检索?关键是找到相似状态下真正有用的转移
五环境比较与混合训练;预测文字相似不等于帮助智能体拿到奖励
研究比较微调、检索增强和简单提示构建文字世界模型,用同一冻结策略提出五个动作,再评价预测后果来选择行动。混合方法在训练时学习读取异回合经验,并先按观察再按动作检索;多数设置收益更高,但任务奖励、语言裁判与训练披露限制了结论外推。
图解主要方法
如何把经验转移变成有助于选动作的世界模型,而不只生成相似描述?
- 1
从环境交互收集状态转移
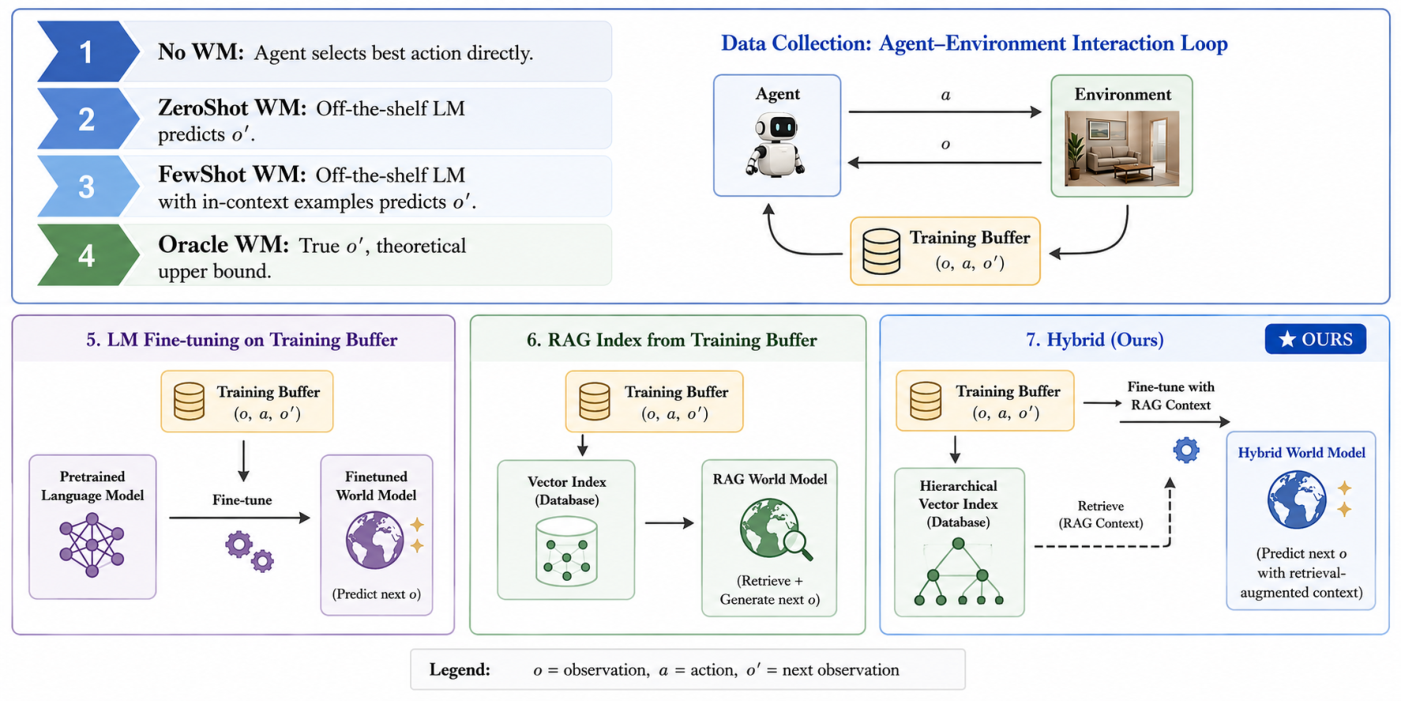
图1右上保存观察o、动作a、下一观察o′。训练采样可混入探索提示产生的动作,探索不是均匀随机抽取;测试时不再使用探索提示。ALFWorld/TextWorld还把房间、库存和合法命令显式加入观察。
- 2
比较把经验写入参数或放入上下文
图1左下FT用下一观察的自回归损失微调;中下RAG不改参数,用Nemotron-Embed-8B检索观察与动作拼接后的五条经验,交给模型预测下一观察。另保留无世界模型、零样本、随机五示例和真实环境对照。
- 3
把观察与动作拆开进行分层检索
先按观察相似度取较大候选池,例如前50条,再按动作相似度重排。这样同样的点击或拿取动作不至于跨完全不同环境状态匹配;相似度等权相加作为另一对照,并非总是更好。
- 4
混合模型在训练时就学习利用检索
图1右下将检索经验与当前观察、动作共同输入,再监督真实下一观察。训练检索排除目标所在完整回合,减少同回合相邻状态泄漏;它限制直接答案捷径,但不能保证跨回合没有近重复。
- 5
用冻结策略评价预测后果
策略提出五个候选动作,世界模型各预测一步,原策略再以1–10分评价对目标的帮助,执行评分最高者。全部预测不可用时回退策略首选。这是一层前瞻选择,不是已验证的任意长程树搜索。
- 6
以反事实替换经验诊断检索
固定当前观察和动作,依次替换候选经验,按预测与真实下一观察的差异给经验伪相关性标签。只在嵌入前20条内寻找最优,因此报告的Recall@5是受限候选上界,不是全经验库的真实召回。
实验与证据
完整阅读63810字符正文、参考文献及附录A–F,视检图1并逐行核对完整结果表;未训练模型或执行环境。
来源证据五环境×四策略模型,共20设置;策略均冻结,使用同样五动作候选流程,实验运行于8张A100集群。 第3节、附录B/E ↗
我的解读主文简称Llama3-8B,附录具体写Llama-3.1-8B-Instruct;训练精确检查点及优化配置尚不充分,不擅自补全。
来源证据单独FT在15/20设置效用高于RAG,但有9/20设置至少一种复杂构建方法被无WM、零样本或少样本基线超过。 表1 ↗
我的解读不能把FT平均较强解读为始终值得训练;先运行便宜基线仍有实证依据。
来源证据混合方法17/20设置领先,作者报告平均达到oracle奖励的77%,下一最佳约60%;并非77%任务成功。 第6节、附录表2 ↗
我的解读归一化依据是同一冻结策略配真实转移的奖励,并不是最优策略。不同环境奖励可有负值,比例平均需要谨慎解释。
来源证据ALFWorld Llama效用FT0.46±0.01、RAG0.36±0.00、混合0.68±0.06;Chameleon Mistral为−3.88、0.64、0.33。 附录表2 ↗
我的解读保留有利和不利例子。附录称区间为95%bootstrap结果,但样本数及奖励定义仍需实现核对,不能据点估计宣称每差值均有稳健显著性。
来源证据TextWorld上RAG保真4.15略高于FT4.04,但效用0.11低于0.15;BLEU和BERTScore对多组结果差异不敏感。 表1、附录表3 ↗
我的解读预测文字更接近不一定有利决策;主文使用Gemma-4-31B裁判,也需警惕裁判与候选模型关联造成的偏好。
来源证据经验规模扫描10–2560条;TextWorld与Sotopia中RAG约40条接近峰值,FT在约80条后明显改善;探索率最优随方法变化。 第4节、附录C ↗
我的解读这些转折来自有限任务和数据设置,不是通用样本复杂度定律;探索由特殊提示实现而非均匀随机动作。
来源证据分层检索TextWorld奖励12.62,相比拼接查询6.50;等权观察/动作分数在WebShop更优,而在部分其他环境下降。 第5节 ↗
我的解读分层是较稳健启发式,仍不是所有环境的最佳检索。反事实相关性评估还依赖生成器与裁判,不能当成独立人工金标。
开放情况与使用许可
2026-10-11阅读论文、arXiv记录并检索标题及代码入口,未核实作者实际公开实现、数据快照或微调权重。论文提供提示与部分环境包装细节,不能据此称全流程开源。
LICENSE论文与图1CC BY 4.0;代码、经验数据和微调产物许可未核实,各基础模型许可分别适用。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
冻结策略、统一五候选动作流程使不同世界模型可以比较;同时看预测保真与下游奖励,避免只用语言流畅度验收。
混合训练排除同回合检索,减少相邻转移直接泄露答案;分开观察与动作检索具有明确环境语义。
反方 · 哪些结论还不够
混合训练17/20设置领先并不普遍:Chameleon的Mistral上RAG效用0.64、混合0.33,Sotopia还有两项微调略优。
主文说误判自己可得负奖励,附录却称固定非伪装者身份使该误判不能发生,这在逻辑上不成立,且表中确有负效用;需实现核实。
真实下一状态被当作oracle不保证下游策略最优;效用77%是相对该固定规划器的奖励归一化,不是任务成功率或一般性能上界。
综合判断
混合经验检索与微调值得作为文字世界模型的强基线,尤其应注意检索的状态条件。结果支持在这些环境中比较方案,尚不足以规定一切世界模型应采用同一训练路线。
我会先做的验证
建议实验,未执行:固定基础模型、经验回合、检索token和推断次数,比较FT、RAG、分层RAG与混合;发布回合隔离划分、奖励代码、完整超参数及每环境样本数。用程序化状态字段评分并增加人工社交复核,检查语言裁判偏好是否改变排名。