World Modeling in Transformers
有内部地图,为什么仍会走错路?把表征、定位和导航分别检验。
研究对曼哈顿随机游走训练的 TaxiGPT 做表征读取与因果干预,发现路网、运行位置和目标方向各有机制。分布外路线中的定位干扰可以解释部分错误,但这不是通用物理世界模拟器。
图解主要方法
模型走错路,是没有学到地图,还是没有可靠调用地图?
- 1
1 · 训练任务与分析对象
训练输入是起点、终点和已有转向 token,输出下一方向或 end;不是从图像重建城市。主要对象为 48 层、1600 维的 GPT-2 型随机游走模型。分析阶段先按路口聚合残差状态,减去总体均值得到 diff-means 路口方向,再在留出行程中读取位置。
- 2
2 · 图 2a:定位依靠过去的位置
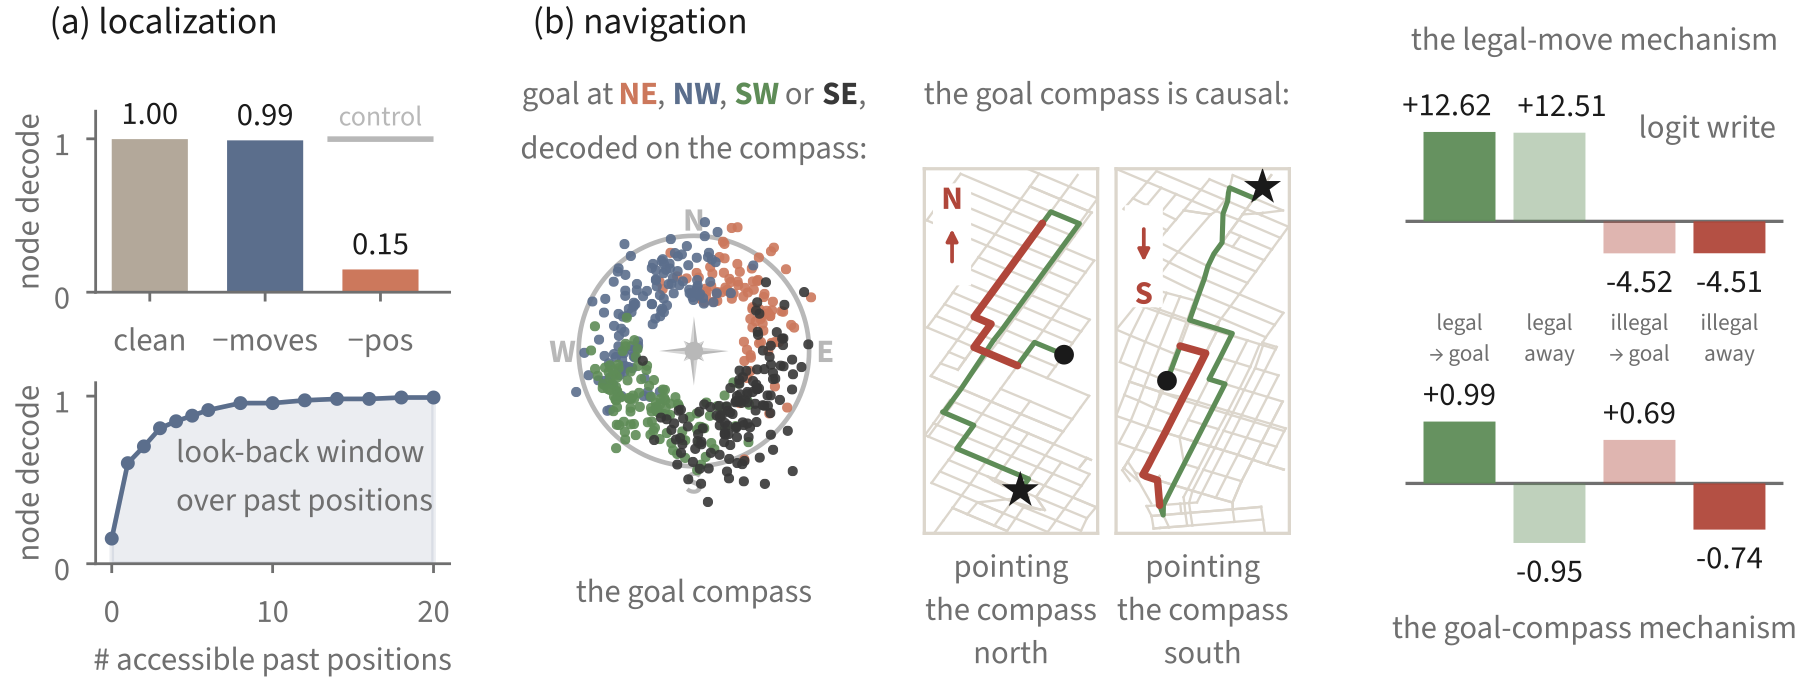
图左 −pos 表示擦除历史位置子空间,−moves 表示擦除历史动作方向。作者重算被编辑 token 的缓存 key/value,仅重跑最终 token,并保留起点、终点和最后动作。27–34 步行程中,删除历史位置令解码从 99.8% 降到 14.8%;同维随机子空间控制仍为 99.8%。这支持滚动位置估计,而不是每次从头累加动作。
- 3
3 · 图 2b:目标指南针从表示到行动
作者按目标方位分成 16 组,用均值差构造余弦/正弦两个方向,形成二维指南针平面。在留出行程上读取方位,再替换或消融该平面。图中朝北、朝南的干预改变路线;这属于推理时激活编辑,没有重新训练导航策略。图示使用较强临时干预,不能和全方位定量扫描的强度混为一谈。
- 4
4 · 图右:合法动作与接近目标分别计分
图中的 legal/illegal 表示路网允许与不允许的转向,goal/away 表示朝向与背离目标。路口机制主要区分是否合法,指南针主要在合法动作中改变目标方向偏好;最终输出仍是 token。只在路网上走而不抵达目标,不能视为成功导航。
- 5
5 · 为什么会错:叠加中的定位信号变弱
4516 个路口方向的 90% 方差集中于 244 维。相似可行动作的路口方向常靠近,某些误定位因此不立即违法;但在深且远的分布外路线中,正确位置写入减弱、其他方向干扰增大,可能激活不适用的转向。作者用削弱信号、加噪、匹配随机编辑及修复实验检验这一解释。
实验与证据
读完正文和附录 A–H,核对分析实现;以下均为作者实验,本站未训练或复现。跨模型训练预算、干预阈值与成功定义不能混用。
来源证据因果路口测试覆盖 4202 个可测试路口、24877 个场景;99.3% 的路口至少有一个场景干预成功,但只有 65.8% 在全部场景成功。 附录 A.2 / 表 3 ↗
我的解读我的解读:不能把“至少一次成功”写成 99.3% 的普遍导航准确率。
来源证据指南针消融:最远起点组为 18–32 步、466 个任务;到达率从 94% 降到 23%,但该组动作合法率仍为 99.5%。采用温度 1、最多 128 步;同维随机平面作为对照。 附录 C.2 / 表 8 ↗
我的解读我的解读:合法性和目标完成是两个独立验收维度。
来源证据大随机游走模型用真实位置逐步强化后,压力测试整条路线合法率为 91.5%→97.3%,绕路到达率为 63.1%→71.9%,压缩分数为 0.524→0.691。 正文 3.2、附录 G 与 oracle_position.py ↗
我的解读我的解读:指标单位不同,且修复依赖 oracle 真值;这是机制证据,不能作为自动纠错产品成绩。
来源证据附录 H:小随机游走模型训练 6 个 epoch,大模型 1 个;在单次训练轨迹中,街道 steering top-5 从 30000 步的 59.3% 降到最终 32.2%,同期 probing 从 72.4% 升至 82.6%。 附录 H / 表 14、16 ↗
我的解读我的解读:训练预算混杂与探针分歧必须保留;作者亦更倾向把 probing 用作街道编码指标。
开放情况与使用许可
已核对固定提交中的 common、experiments 实现及 MIT LICENSE;仓库不包含数据、权重和训练代码。作者页面的交互面板仍标记 coming soon,不算已开放演示。
LICENSE论文 CC BY 4.0;原创分析代码 MIT,第三方文件保留各自许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
读取、置换、消融与匹配随机方向控制形成互补证据:并非只有“能从激活读出地图”的相关性结果。
指南针消融后合法性仍高而到达率下降,说明任务总分确实掩盖了不同机制。
反方 · 哪些结论还不够
强化真实位置的实验给模型额外状态信息,证明位置表示有用,却不证明模型能自行纠正漂移。
小模型随机游走训练约 284.1 亿 token,大模型约 47.4 亿;更好行为不能归因于更小宽度或 NextLat 目标本身。不同读出法、层选择和任务条件也会改变指标。
训练后期街道 steering 指标下降而 probing 上升;人工平均提示与模型自然使用的历史窗口不同,不能把任何一种探针当完整能力量表。
综合判断
我的判断:这是一篇有因果证据的机制诊断研究,支持“地图表征与可靠使用应分别评价”。它没有证明通用大模型已具备完备世界模型,也没有消除真实导航失败。
我会先做的验证
建议实验,尚未执行:固定数据、训练 token、随机种子组与容量,比较 NTP/NextLat;在独立城市图上同时报告完整行程到达率、非法动作、位置解码、随机子空间控制。将真实位置强化与模型自主估计修复分列,避免 oracle 信息混入部署成绩。