World Observer:镜头转开以后,让另一个生成视角继续维护世界
主视角与全景观察者联合生成,区分物体重现和运动真正延续
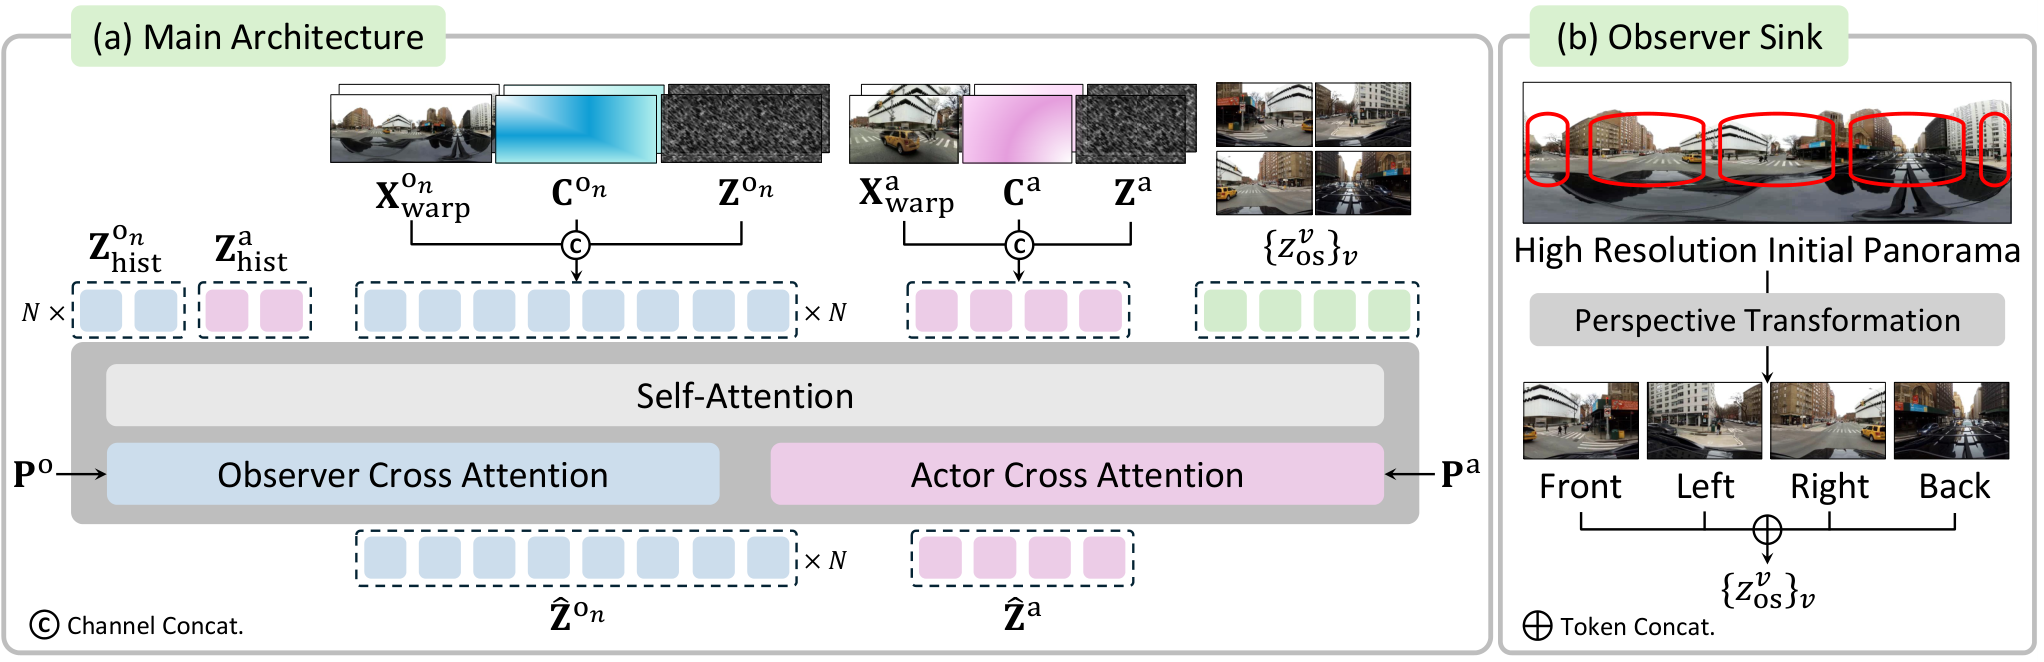
模型把透视主视角和低分辨率全景观察者放入同一个视频Transformer,同一时刻的token交换状态。全景初始图的几何投影提供对应关系,四个高分辨率透视裁剪保留外观。它改善镜头外物体重现后的运动一致性,但“观察者”也是生成的视频,不是新获得的真实观测。
图解主要方法
镜头外物体回来时,模型能否既保留身份又延续正确运动?
- 1
先制作同步的主视角与全景条件
真实全景视频先用COLMAP稳定旋转、GeoCalib校准重力,再裁出不同旋转轨迹的透视视频。多个重叠透视深度估计合成全景深度;CARLA则同步渲染移动主视角与两个静止全景位置,提供真实数据缺少的分离配置。
- 2
把多个视频流放在同一个去噪序列中
Cosmos-Predict2.5的2B DiT联合处理主视角、观察者及最近历史,同一时刻采用相同时间RoPE位置;不同视角有可学习标识。自注意力交换各视角状态,分开的文字交叉注意力分别控制主视角事件和镜头外事件。
- 3
用共同投影与外观参考连接两种视角
初始全景与深度沿各相机轨迹投影,连同有效像素mask和Plücker射线提供几何对应。Observer Sink将初始全景裁成四个相隔90度的高分辨率透视参考,保持固定、供生成token查询;这些外观参考不负责动态演化。
- 4
用观察者延续动态,再按块滚动
主视角1280×704,观察者640×320,以较低成本覆盖四周。每段77帧,下一段保留前段末尾两个latent、对应5帧;多观察者时每帧选择离主视角最近的初始全景作投影来源,外观参考按该段首帧选择。全部观察者仍共同生成,而非来自在线真实摄像头。
- 5
分开衡量重现覆盖与位移一致性
SAM3分割和DA3深度把对象提升到三维,比较出镜前与再入镜后的位移。OOV-F统计有效离开并返回比例;OOV-Dgt比较真实参考位移,OOV-Dself比较出镜前运动。两种位移评分只对返回子集计算,方向和长度均须匹配才得高分。
实验与证据
完整阅读正文与附录A–E全部91530字符,查看图4,打开作者项目页并核对GitHub实际文件树与发布计划;没有独立训练或复现实验。
来源证据138K片段来自23K真实视频,72K来自12K合成视频;训练采样60%真实、40%合成。单观察者8张H100、12K步、batch16;双观察者再用合成数据6K步、batch8。 第4.2节、附录B ↗
我的解读双观察者结果有额外训练且只在合成基准出现;不能视为不增加训练成本的真实世界普遍改进。
来源证据两个留出基准各100段、每段77帧,单段全部在上下文内;场景少于10动态对象,人工挑选1–3个明确出镜并返回对象。 第4.2节、附录C.1 ↗
我的解读基准隔离镜头外状态问题,但不是拥挤场景或长期记忆测试。训练与评测来自相同来源的留出视频,真实跨域证据有限。
来源证据真实集单观察者OOV-F为0.492,OmniRoam为0.563、Matrix-Game-3为0.568;合成双观察者0.722,OmniRoam0.875。 表1、附录C.3 ↗
我的解读作者方法位移一致性较强,但返回覆盖率并非全部领先;不同返回子集还会影响OOV-D的可比性。
来源证据单观察者真实/合成FID为29.30/19.65,FVD为291.7/196.2;合成图像质量0.641,低于LingBot-World的0.675及Matrix-Game-3的0.689。 表1 ↗
我的解读视觉分布距离改善与单帧质量评分是不同指标;不宜把“整体较强”改写成画质所有指标第一。100段基准也需报告估计不确定性。
来源证据相机评测对生成和参考都使用DA3,包括CARLA;每条平移轨迹分别按最大平移范数归一化。静态区域mPSNR/mLPIPS排除SAM3检测的动态对象。 附录C.2 ↗
我的解读相同估计器不保证偏差自动抵消;归一化平移误差不是绝对米级位置误差,静态外观一致也不能代替动态物理一致。
来源证据Observer Sink去除后合成OOV-Dself由0.526降至0.470,FID由19.65变为20.33;主表各基线使用其可接受的条件,HyDRA采用原生前段上下文/后段重建协议。 表2、附录C.3与C.5 ↗
我的解读消融支持外观参考有帮助,跨架构主表还混合了输入和协议差异。OOV-Dself偏好延续原运动,合理的突然转向或停步可能受罚,需针对非匀速事件补测。
开放情况与使用许可
2026-10-11打开官方项目和仓库,文件树提交6efb6a4107f53e7e36031cfa00c880b075631fcf仅见网页、图片、演示视频及README。训练数据、权重和推理代码、训练代码三项均为未勾选发布计划,不能标为已开源模型。
LICENSE论文及图4为CC BY 4.0;所查仓库无LICENSE文件,尚未发布的代码、权重和数据许可未确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
单观察者真实/合成OOV-Dgt为0.426/0.531,OOV-Dself为0.408/0.526;同条件移除观察者后合成值降至0.387/0.430。
合成环境双观察者把有效离开再进入覆盖率从0.580提高至0.722,支持更多视角对遮挡覆盖有帮助。
反方 · 哪些结论还不够
双观察者OOV-Dself反而从0.526降到0.457,OOV-Dgt也从0.531略降0.528;覆盖更大不等于每个返回对象都更准确。
OOV-D仅统计成功离开再返回的对象,各模型统计子集不同,必须和OOV-F同时看,不能用单个高分掩盖丢失。
动态文字描述来自完整视频,包含镜头外事件;这验证按给定事件生成世界的能力,不是从初始画面独立预测未知未来。
综合判断
联合全景状态是值得关注的表示设计,且评测主动区分重现与位移。但是“持续观察”应理解为持续生成内部视角,不能据此宣称恢复了真实不可见过程,或已证明长时间稳定和真实多观察者泛化。
我会先做的验证
建议实验,未执行:在真实同步多相机留出集上,以仅初始信息和含未来事件提示两种协议分别评测;使用人工身份标注及真实深度/位姿复核指标,按所有目标统计并报告置信区间,增加转弯、停走、交互与多段自回归的漂移曲线及计算成本。