world2vec:不重建像素,也不靠奖励学习动力学表示
可预测潜空间能否同时用于规划和可解释动力学发现?
用神经微分方程预测编码后的未来状态,再以对比或分布正则防止表示坍塌。三种视觉控制任务中两种优于对照,但Cartpole明显落后;符号方程恢复依赖更理想化的数据条件,应与视觉控制分开看。
图解主要方法
可预测潜空间能否同时用于规划和可解释动力学发现?
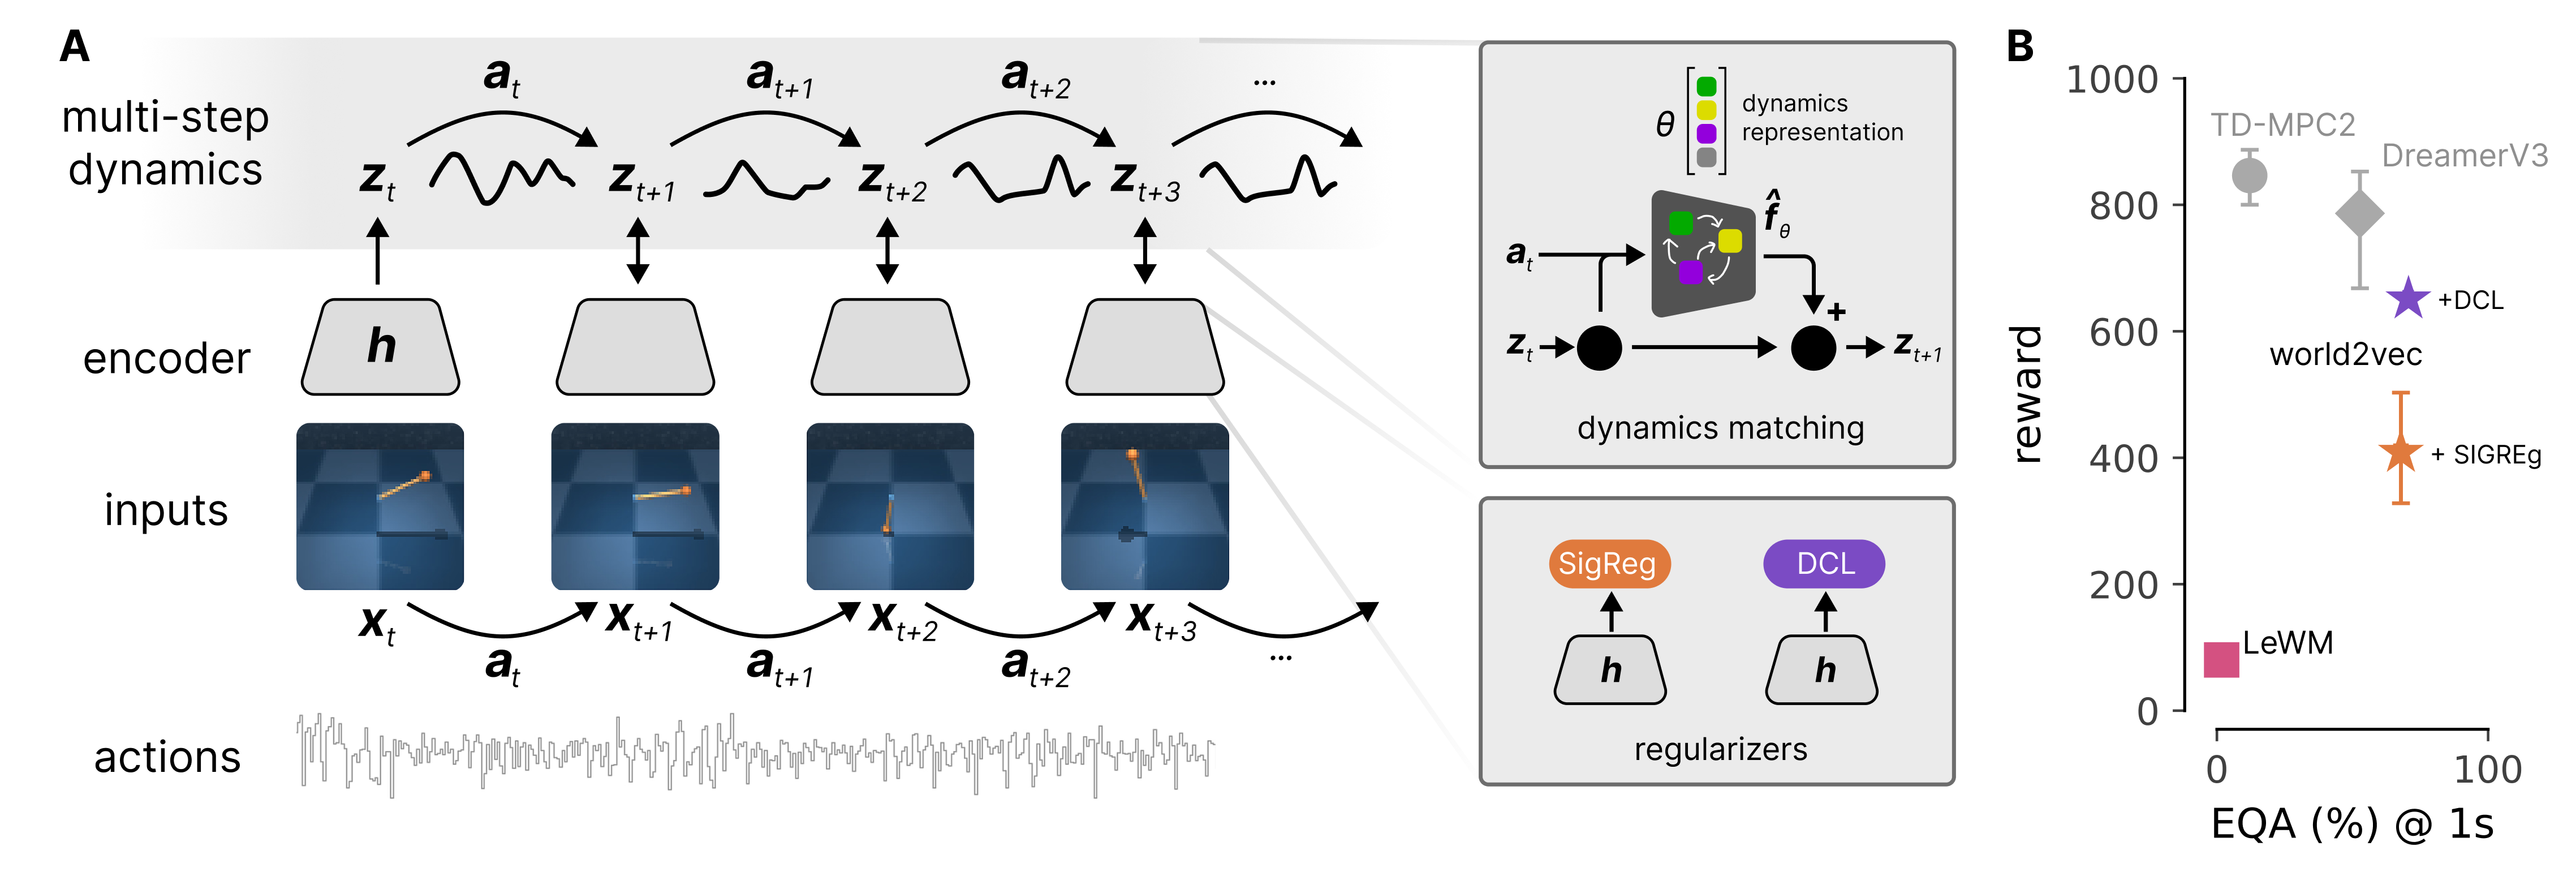
- 1
图1A:编码观察,学习连续潜在变化
视觉控制将三帧输入编码成32维状态,神经ODE的MLP向量场结合动作,用Euler积分预测潜在轨迹。训练只要求多步预测与未来观察编码相符,不用RGB重建损失或任务奖励;滚动长度10/20/40使表示必须保留动态可预测因素。
- 2
图1C:防止所有输入变成同一个向量
单靠预测损失,常数表示也能取巧。DCL用负样本对比,另一版本SIGReg约束潜变量分布接近高斯;论文同时看长程一致性LRC与嵌入质量EQA,避免把坍塌后的低误差误称为好世界模型。
- 3
图1B:把目标图变成规划目标
CEM在潜空间滚动候选动作,按预测状态与目标图编码距离选动作。Reacher目标图用逆运动学生成,带有额外环境知识;连续时间模型可更换积分和控制频率,但频率迁移测试不代表任意动力学和采样率都能迁移。
- 4
符号发现是另一套更理想的设置
在71个dysts吸引子的混合观测上先学习动力学表示,再用稀疏多项式SINDy拟合方程;该设置用RK4和单步损失,不是视觉控制的Euler多步方案。噪声与可辨识性假设支持仿射恢复;选最一致候选后还用真值对齐,不能说全部系统都自动恢复原物理变量。
实验与证据
已阅读PDF完整主文及方法、控制与符号动力学实验;HTML缺失部分由PDF补足,核对实验条件与原图;未独立复现。
来源证据每环境200K随机策略64×64图像训练约263K参数模型、20000步。DCL的LRC97.7、EQA70.7;Reacher/Pendulum/Cartpole奖励895/826/232,DreamerV3为792/668/899。 PDF主文表1与控制协议 ↗
我的解读我的解读:两胜一负且Cartpole差距大,预测表示并不保证所有控制任务成功。部分在线基线的数据来源和控制频率不同,不是完全同预算算法排名。
来源证据Reacher目标规划25Hz、200步成功率80.2%,LeWM52.9%,规划耗时2.55秒对8.64秒;另一重定时例子从10Hz训练到50Hz积分、25Hz控制,奖励903→952。 目标规划与频率实验 ↗
我的解读我的解读:小模型规划效率有价值,但单任务频率例子与约80%成功不足以外推到复杂机器人,目标生成的额外条件也必须保留。
开放情况与使用许可
论文公开;HTML正文存在缺失,已改读PDF主文及实验。未核实可运行官方实现与权重许可,因此保持实现开放待核。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:放弃像素重建可避免把容量耗在任务无关外观;同时测可预测性和抗坍塌,给奖励无关世界模型一个可分析的小规模实验框架。
反方 · 哪些结论还不够
视觉任务仅三个,符号实验依赖理想混合与噪声假设,潜变量一致不等于语义可解释。真值辅助的目标生成及候选筛选削弱完全自发现的表述。
综合判断
适合作为表示学习与动力学辨识的研究基线;尚不能据此替代真实复杂环境中的视觉世界模型。
我会先做的验证
未执行的验证方案:固定随机数据和规划预算,在遮挡、颜色变化及动作延迟下比较DCL、SIGReg和像素重建;同时报告坍塌指标、控制成功率与频率迁移误差,符号实验额外禁止真值筛选,统计全部系统而非精选例子。