WorldCast:从一张正确图片走向多步骤世界状态预测
过程、因果与一致性分别评分后,生成系统还剩哪些缺口?
WorldCast用320个案例、1352个目标视觉状态检验多步骤生成,把任务完成、因果合理和视觉一致性分开。高分系统仍会漏部件或跳过关键阶段;72.8是综合评分,不是任务成功率。
图解主要方法
过程、因果与一致性分别评分后,生成系统还剩哪些缺口?
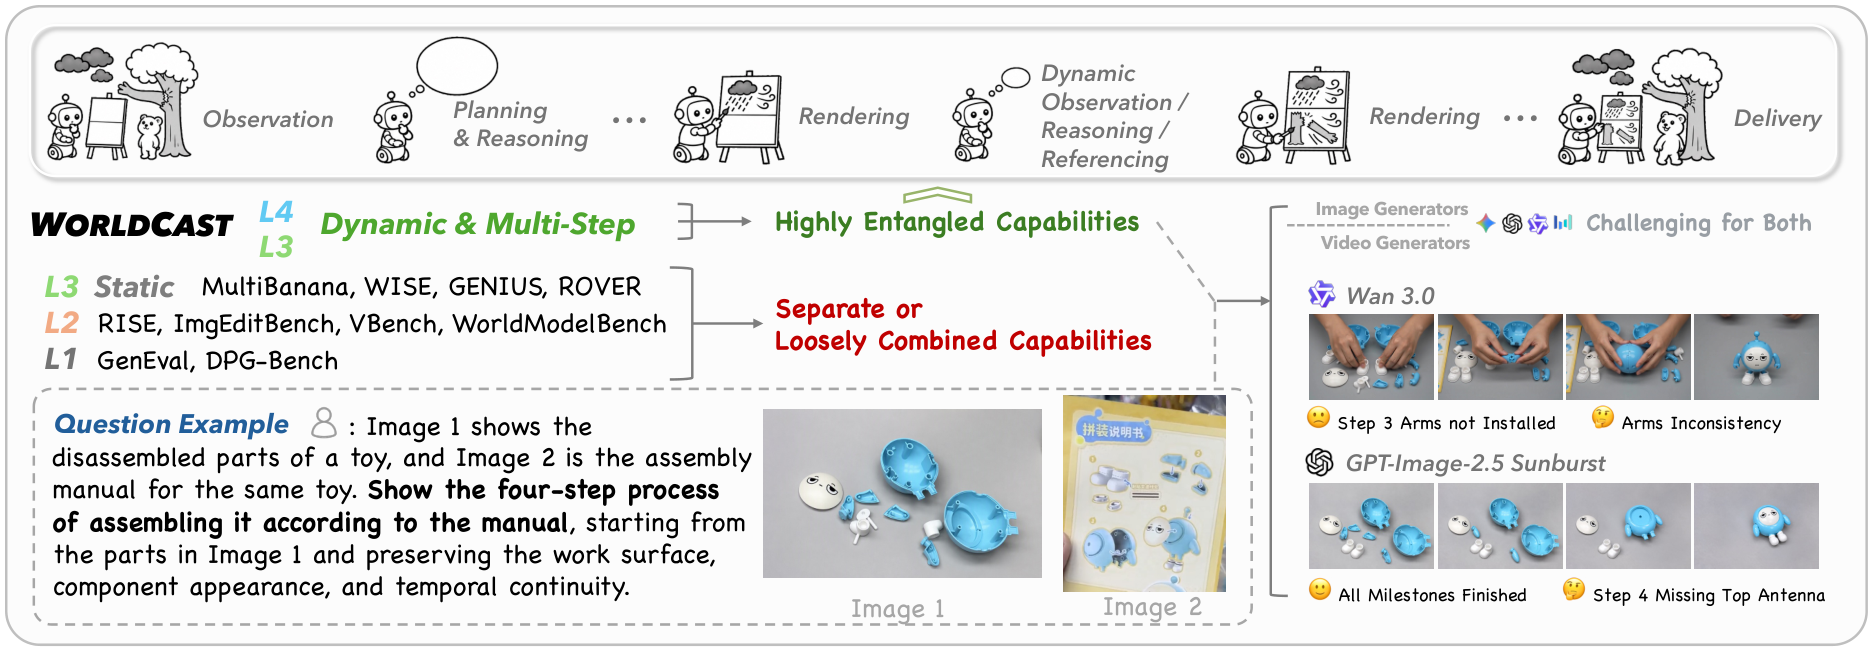
- 1
01 · 用多模态条件定义连续状态
八类题覆盖观察条件转移、物理变化、任务执行、视觉线索、性质推断、目标达成、规则和程序迁移。图2要求按说明书组装同一玩具,既检查阶段顺序,也检查零件身份保留;单一终态漂亮不足以过关。
- 2
02 · 将图像和视频转成可比较的状态序列
图像采用交错多图或拼图输出,视频由代理挑选指定里程碑帧。视频适配器会为缺失里程碑选择最接近帧并标记未实现,因此这是关键状态检查,不能据此评价整个视频的全部运动连续性。
- 3
03 · 拆开任务、因果与视觉连续性
任务完成TC结合过程对齐与最终结果,因果合理CP检查前提、接触和对象守恒,视觉一致VC检查身份及几何漂移。统一到同一尺度后按0.4、0.4、0.2加权转成百分制;逐题给裁判的提示不提供给生成模型。
- 4
04 · 比较生成接口与额外推理
除了直接生成,还让代理检查、修改,并可先编写几何或过程代码、渲染检查后再指导图像生成。图像调用预算统一,但额外代码、工具时间并不相同;因此增强系统结果要与基础模型分开报告。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据12种系统中GPT-Image-2.5系统72.8,Nano Banana Pro42.8;三轮生成整体均分标准差不超过0.53,但类别可达2.7。 主表与附录E ↗
我的解读分数是裁判加权量表;不同系统含不同理解模型,不能简单解释为生成器单独能力的排行。
来源证据GPT-Image-2.5由交错图转拼图降至50.1;检查循环升至80.2,鼓励先写代码为82.4。Nano的GPT-6增强基线为61.2,再到72.5与72.9,不能用42.8替代其对应基线。 生成接口与代码增强 ↗
我的解读接口与推理投入改变结果显著;改善来自完整系统,而且代码并非对所有题都有帮助。
来源证据6位专家评估5个系统,模型级胜率相关至少0.97;100个视频的自动与人工选帧分数相关0.9546。 人工与裁判验证 ↗
我的解读只有5个聚合点的高相关不能说明逐题判分完全可靠,选帧对照也不等同于真实物理验证。
来源证据主要裁判GPT-5.5 medium;视频适配与部分增强使用GPT-6 Astra。增强每题最多2N次图像调用、150分钟时间预算,部分案例耗时超过1小时。 附录执行协议 ↗
我的解读等图像调用数并不等计算量、费用或交付时间,生产管线仍需独立比较性价比。
开放情况与使用许可
2026-10-18已核对论文全文及附录,未从论文入口确认本工作可下载的官方基准包、评测仓库与独立许可证;保持待核状态,不把文中受测模型的仓库当作WorldCast代码。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把正确终态、合理过程和身份一致拆开,能发现单图评分看不见的漏步骤、凭空出现零件和接触不成立问题。
反方 · 哪些结论还不够
320题手工设计、有限裁判验证;部分参考图经生成增强,存在来源和偏差问题。关键帧评测会遗漏帧间动力学,组合系统的差异不能归因于单一模型。
综合判断
适合作为多步生成评测设计参考,而非世界模型已具真实物理能力的证明;与同名但不同arXiv编号工作区分收录。
我会先做的验证
未执行的验证方案:独立设计未公开的装配与物体守恒题,固定生成模型、理解模型和端到端预算,盲评完整视频与里程碑帧,报告逐题一致性及模型拒答情况。