WorldMemBench:回头三次,世界还记得什么?
静态场景记得住,是否也能记住镜头外正在发生的变化?
WorldMemBench 用离开再返回的轨迹分别评估人物、物体、环境与动态事件。260个案例将静态保留、事件推进、画质和相机执行分开报告;固定初始参考可暴露反复回访后的累积漂移,而事件启动门槛揭示“没有发生”与“发生后忘记”是两种失败。
图解主要方法
静态场景记得住,是否也能记住镜头外正在发生的变化?
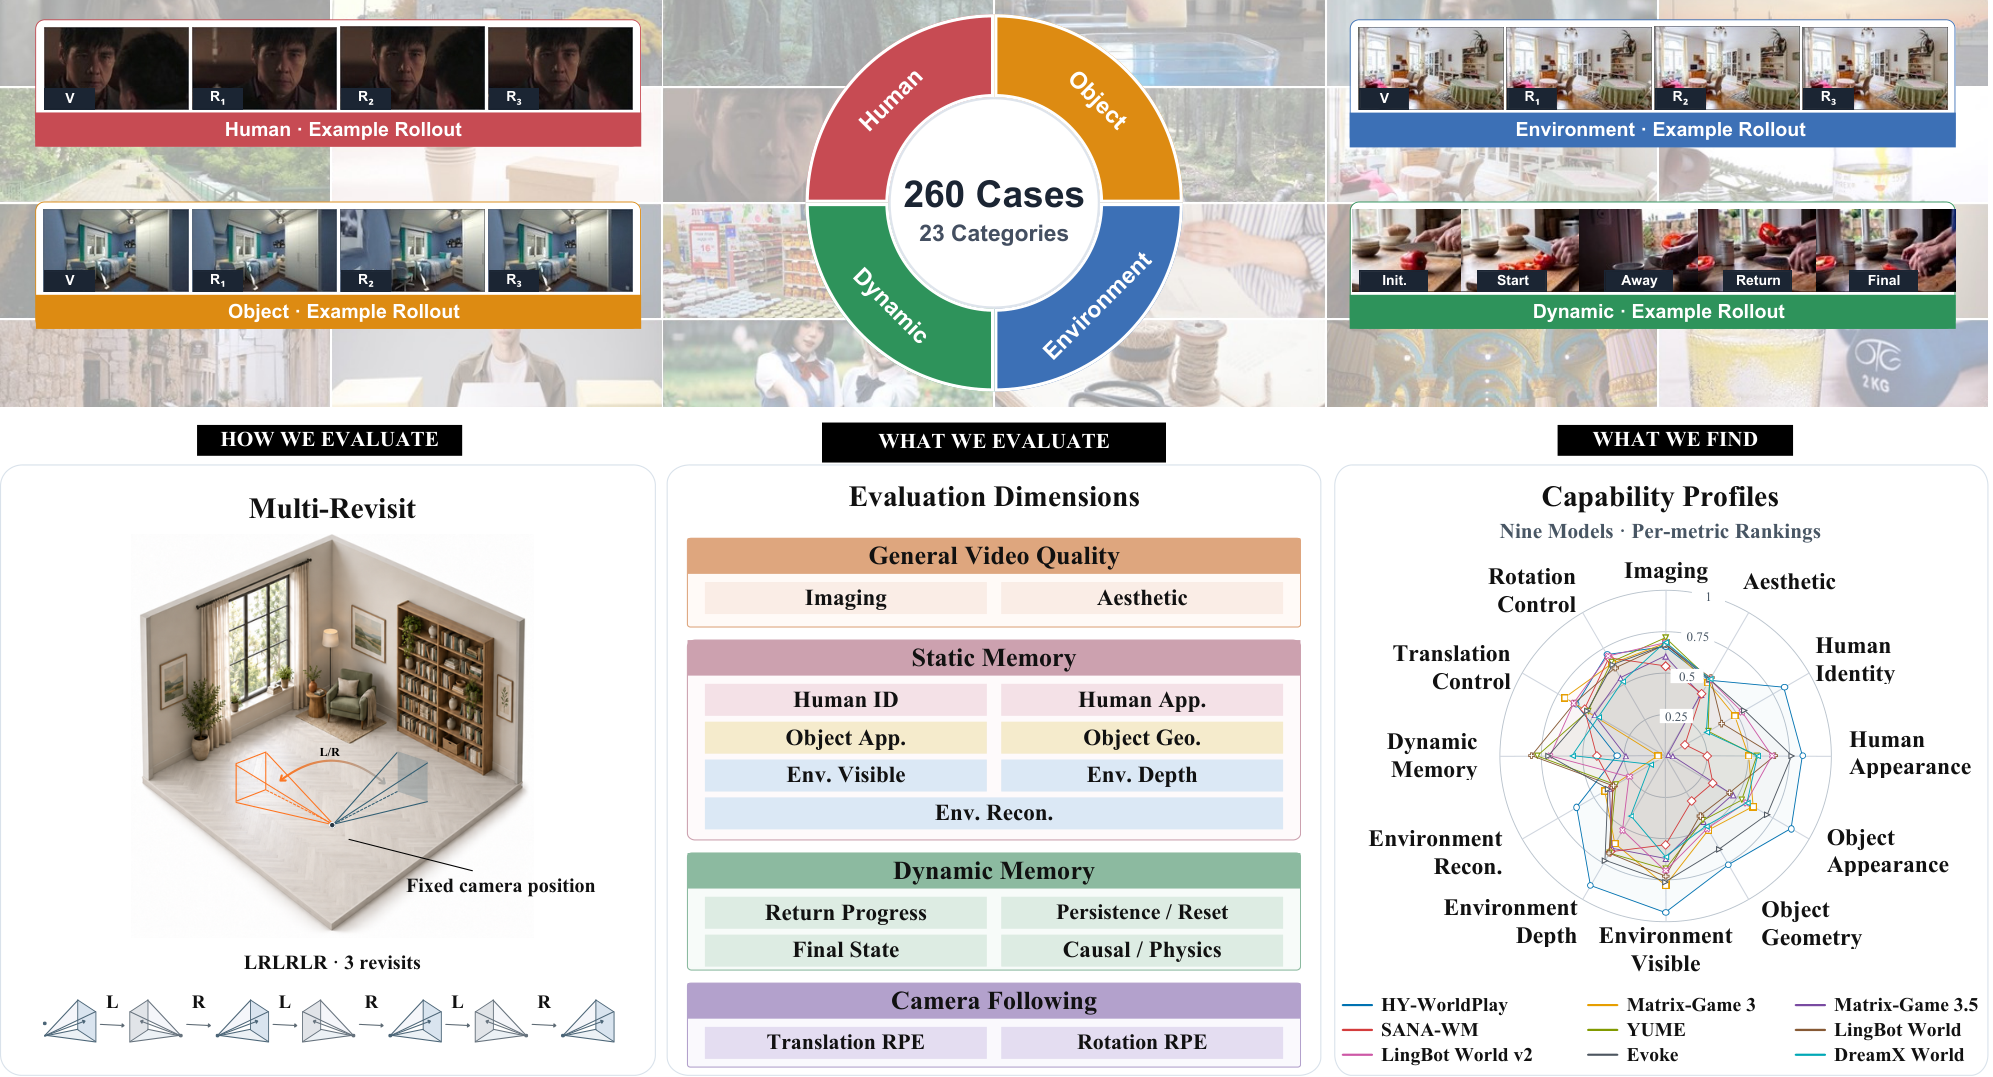
- 1
构造可比较的离开与回访
图1包含200个静态与60个动态案例、23类内容。LRLRLR表示三次左右转动返回,LRUD在第二次换成俯仰轴;平移采用闭环。每次返回都比对最初参考,而不是上一轮已漂移的画面,缺失有效目标的回访仍进入分母并计零。
- 2
按对象性质分开记忆指标
人物用脸部身份特征和掩码内DINO外观;物体另比较归一化轮廓IoU。环境比较整体外观、深度排序及尺度对齐后的球面表面。轮廓相似或单目深度估计不能直接当作真实三维几何正确性。
- 3
动态事件先确认开始,再判断后果
每例固定初态、动作和期望后态,Qwen3.8-27B根据按时间采样的图像回答8个二元问题,覆盖进展、持续、最终状态、因果物理。若初始停留阶段未见事件开始,8项全部计零;总分等于启动率乘启动子集条件得分。
- 4
单独控制镜头执行与上下文预算
使用估计相机轨迹报告旋转和平移误差,再在确实离开且返回的子集复核记忆衰减。LingBot-World-v2的诊断固定模型与种子,只改变完整KV、20潜帧滑窗或20潜帧视野检索,区分上下文选择与重新训练。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据HY-WorldPlay在七项静态指标领先,但仅19/60事件启动:启动率31.7%、条件分0.928、门控总分0.294。LingBot-World启动56/60、条件分0.866、总分0.808。 九模型、260案例与动态分解 ↗
我的解读我的解读:不能仅看门控总分就断言前者动态记忆差;两者启动子集不同,条件分也不是纯粹且公平的记忆排名。
来源证据按离开至少30°且返回误差不超过30°筛选431个环境模型—案例对,第三次相比第一次,外观、深度、重建分分别下降0.152、0.135、0.139。收紧到5°仍见平均退化,但跨轴只剩4模型30对。 附录G:真正返回的子集仍会退化 ↗
我的解读我的解读:结果不完全由镜头没回去解释,但残余位置偏差、遮挡和估计误差仍存在,不能把余量全归为遗忘。
来源证据静态504对、三人共1512判断,六指标方向一致率78.5–92.5%,环境深度模型排名相关仅0.301。动态50例总体Spearman0.732,因果物理0.401。660条匹配视频中FoV平均262.69秒对FullKV322.16秒,约1.23倍。 人评与上下文诊断 ↗
我的解读我的解读:自动评审不是物理真值;FoV在物体外观、形状及环境可见性仍落后完整历史,不能只摘8/11指标领先。
开放情况与使用许可
已核实官方仓库有评估源码、脚本与MIT LICENSE;Hugging Face有视频及评估产物文件。数据和第三方模型另有条款,不能套用代码MIT;本次未独立运行评测。 发布说明不包含被测模型推理实现与checkpoint,部分种子未保存,不能承诺逐位重生成全部归档视频。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:固定参考、多次回访和启动分解能抓到画质榜单遗漏的持久状态问题,适合作为交互世界模型的独立验收层。
反方 · 哪些结论还不够
各模型使用原生分辨率、帧率和控制接口,时长约20–35秒;自动人脸、分割、深度与VLM误差会传入得分,尚未覆盖自由长程、多主体交互。
综合判断
适合诊断相机控制下的记忆衰减,不能把该榜单作为现实物理模拟或无限长世界持久性的认证。
我会先做的验证
未执行的验证方案:保持同一批内容和生成预算,交叉改变离开时长、返回次数与旋转轴;人工复核事件启动、相机返回和物理后果,分别报告门控与条件分及置信区间。