WorldPlay2:连续导航、语义事件与压缩历史一起生成
16FPS使用8张H20;长视频一致性仍不等于持久物理世界
WorldPlay2把逐帧导航与场景、人物、事件提示分开编码,再用压缩历史支持自回归生成。Stable Forcing通过长rollout回放进行少步蒸馏,减少生成漂移;结果显示控制与长程质量改善,但吞吐依赖多卡系统,事件评分和记忆压缩也仍有代价。
图解主要方法
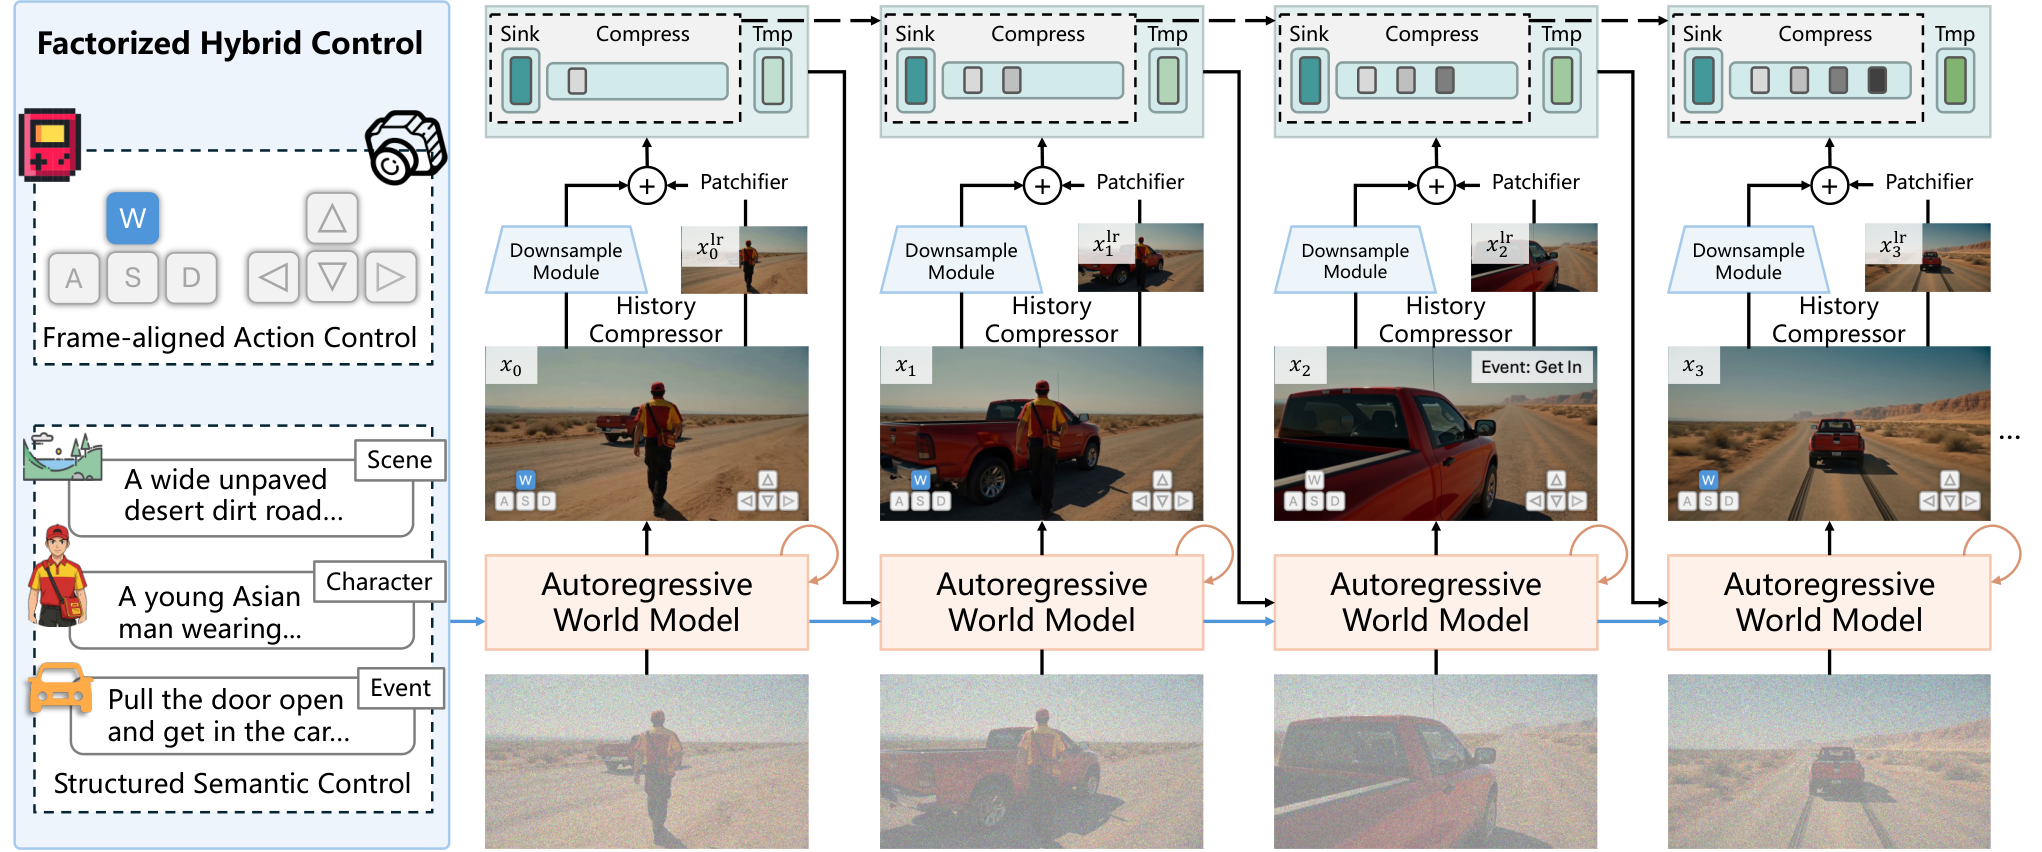
图2中的控制分解、历史压缩和生成循环如何协同,少步训练又怎样看见长程误差?
- 1
把几何控制与语义事件分开输入
连续俯仰/偏航用MLP编码,WASD、转向、跳跃等离散动作逐帧对齐注入主干;场景、人物、事件单独形成语义控制。这样的因子化接口能减少互相干扰,但输入控制信号不等于生成结果每帧都严格遵守物理约束。
- 2
保留近邻并压缩远期历史
记忆包含起始sink、粗细压缩历史和邻近帧;历史时间下采样2、空间4,使token约缩到1/32。因果3D卷积避免泄露未来,教师和学生都能使用记忆;压缩仍会丢细节,也没有证明任意长时间内存始终恒定。
- 3
先少步初始化,再回放长rollout
PDD先得到少步学生,Stable Forcing无梯度展开320潜帧并缓存中间去噪状态,再由教师分段评分、重放选定步骤的梯度。它让训练见到学生累积误差,同时避免整段反向传播;不是完整长序列BPTT。
- 4
把模型算法与系统加速共同核算
部署使用4步生成、FP8、图执行、KV与LightVAE等优化。论文报告的是8张H20的16FPS及约一秒一块延迟,不能直接写成单卡实时16Hz控制响应;长程复访仍依赖压缩记忆保留下来的信息。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【交互与质量】WBench总83.1对前代82,质量81.8略低于81.9,场景81.5低于82.1,物理分74持平。 WBench结果表 ↗
我的解读我的解读:总分提高不代表每项领先,更不能由视频评分证明真实物理定律。
来源证据【事件与记忆】145个事件由VLM评学生74.7%,对照52.5%,教师84%;压缩记忆SSIM0.653低于完整记忆0.688,LPIPS0.414高于0.406。 事件评测、记忆消融 ↗
我的解读我的解读:可控性有收益,但教师/学生须分开,压缩不是完全无损;VLM判断还需人工和状态级审计。
来源证据【时延与范围】8×H20达到16FPS,LightVAE等使块延迟从3.432秒降至0.998秒;Revisit200含50段10秒和150段30秒。 效率表、Revisit200与附录 ↗
我的解读我的解读:吞吐、响应延迟和长程范围是不同指标,有限复访集不能证明无限持续一致。
开放情况与使用许可
已打开项目页和GitHub并核对文件树:当前只有README,明确写代码和权重仍在整理。论文及演示公开,不能称代码或模型开源。
LICENSE未见实现或权重许可;论文图2为CC BY-NC-SA 4.0,与未来代码和模型授权分开。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
同时处理导航动作、事件语义和长历史,并用学生自己的长rollout做蒸馏,贴近交互生成瓶颈。
反方 · 哪些结论还不够
多卡成本、压缩损失、VLM评分及有限复访范围限制真实持久世界主张;公开仓库尚无实现。
综合判断
是可控交互视频的重要进展;作为规划模拟器还需可追踪状态、因果响应及重复动作一致性证据。
我会先做的验证
未执行的验证方案:固定硬件、分辨率和总延迟,对完整/压缩记忆及不同蒸馏长度做消融;连续重复闭环路径、遮挡再现和冲突事件,测身份、空间回环、动作因果、P95响应与显存随时间增长。